گزارش یعنی صف انتظار
مدیر مالی یک سوال ساده دارد: «در سه ماه گذشته، کدام پیمانکارها بیشتر از دو قرارداد با تاخیر تحویل داشتهاند؟» جواب، در واقع، همین حالا در دیتابیس سازمان نشسته است. با این حال بین سوال و جواب یک مسیر آشنا قرار دارد: درخواست به واحد فناوری اطلاعات، انتظار برای کارشناسی که SQL بنویسد، فایل اکسلی که یک روز بعد میرسد، و سوال دومی که همین چرخه را از اول شروع میکند.
مشکل کمبود داده نیست. مشکل فاصلهی داده تا آدمی است که به آن نیاز دارد.
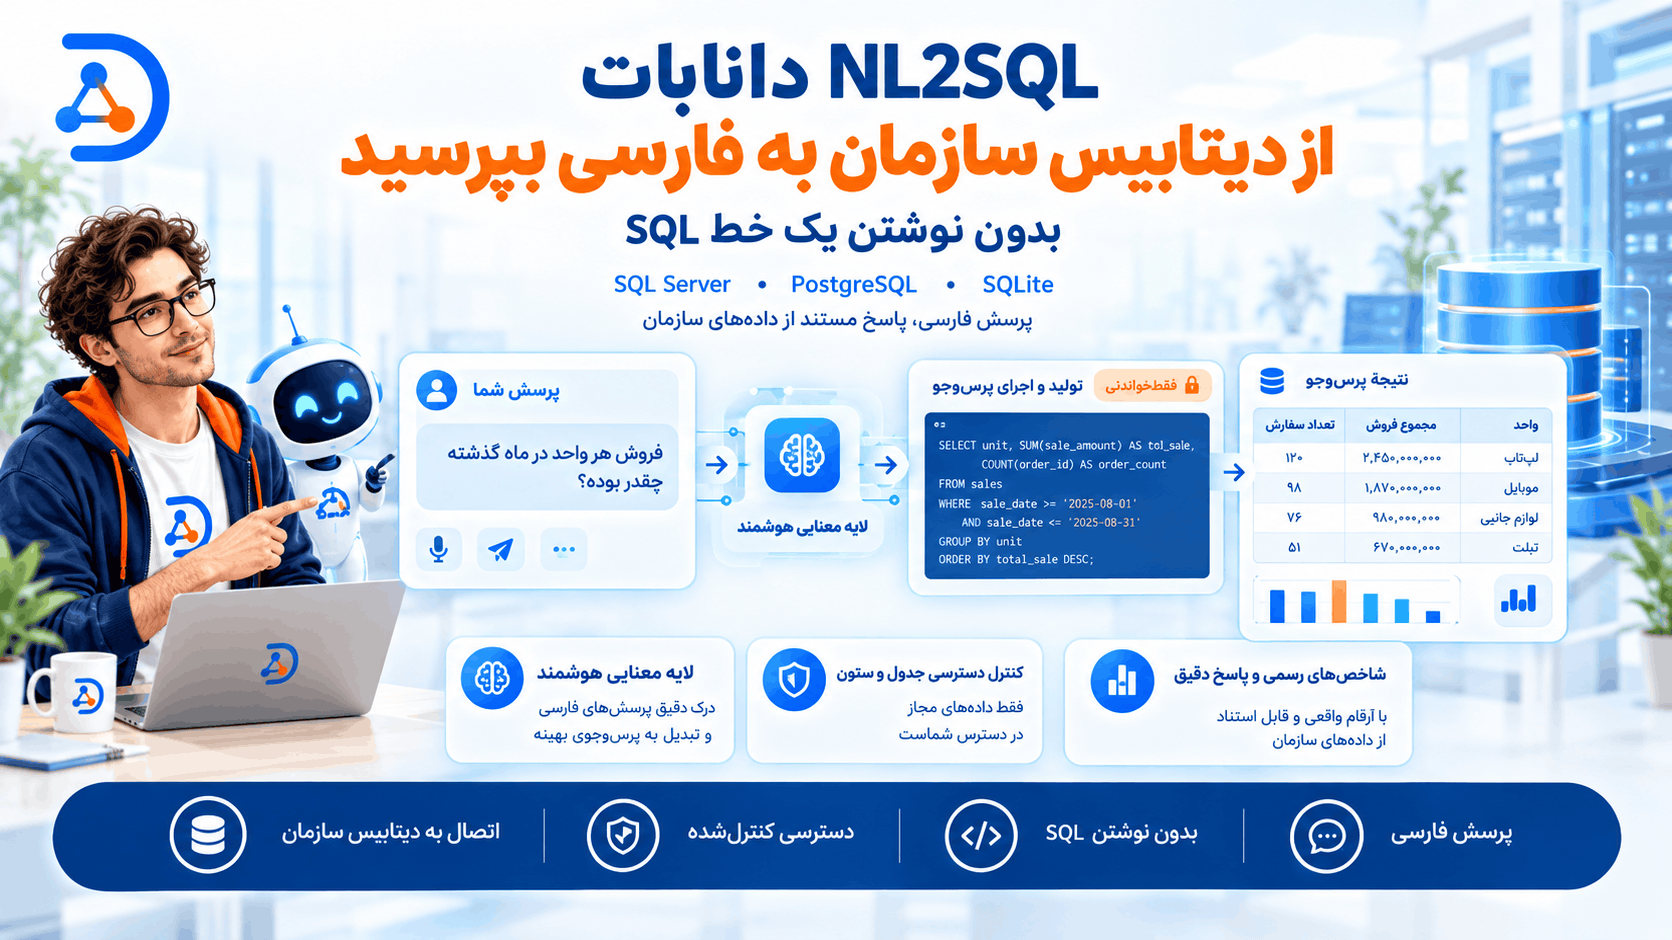
ماژول NL2SQL در دانابات برای بستن همین فاصله ساخته شده است: سوال را به فارسی میپرسید، سامانه آن را به یک پرسش فقطخواندنی روی دیتابیس تبدیل میکند و نتیجه را به شکل جدول یا نمودار برمیگرداند. روی کاغذ ساده به نظر میرسد. اما بخش سخت ماجرا همان چیزی است که بین این دو نقطه اتفاق میافتد، و بیشتر این مقاله دربارهی همان است.
NL2SQL دقیقاً چیست، و چه چیزی نیست
NL2SQL یعنی تبدیل زبان طبیعی به SQL. در دانابات این تبدیل روی SQL Server، PostgreSQL و SQLite کار میکند و خروجی آن همیشه فقطخواندنی است. سامانه میتواند از دیتابیس بپرسد؛ نمیتواند چیزی در آن بنویسد، حذف کند یا تغییر دهد.
چند چیز را همین ابتدا روشن کنیم تا انتظار اشتباه شکل نگیرد. این ماژول جایگزین انبار داده یا یک پروژهی کامل هوش تجاری نیست. جادو هم نیست؛ کیفیتش به ساختار دیتابیس شما و به تعریف روشن شاخصها بستگی دارد، و در بخش محدودیتها صریحتر به آن برمیگردیم. ثبت یا تغییر اطلاعات را هم انجام نمیدهد: اقدام روی سامانهها در دانابات مسیر جداگانهای دارد و هر اقدامی که وضعیت سامانه را عوض کند، تایید صریح کاربر میخواهد.
کاری که NL2SQL میکند باریک است، اما دقیقاً همان کاری است که مدیران هر روز لازم دارند: پرسیدن.
اگر در مقالهی SmartConnect؛ دستیار برای هر سامانه بدون بازنویسی خوانده باشید، تصویر کلی را میشناسید. SmartConnect به دانابات حواس میدهد تا نامهها، تیکتها و قراردادهای سامانههای مختلف را بفهمد. NL2SQL همتای آن برای دادهی ساختیافته است: جدولها، رکوردها و اعدادی که در دیتابیس عملیاتی سازمان زندگی میکنند.
چرا وصل کردن یک مدل زبانی به دیتابیس کافی نیست
ایدهی اولیه وسوسهانگیز است: یک مدل زبانی بزرگ، اسکیمای دیتابیس، و یک کادر چت. در دمو هم معمولاً خوب کار میکند. اما دیتابیس واقعی سازمان چهار مانع دارد که دمو سراغشان نمیرود.
اول، نامها. ستونی به اسم cust_stat_cd برای مدل چیزی نمیگوید و برای سوال «مشتریان غیرفعال» مسیر روشنی نشان نمیدهد. دوم، روابط. در دیتابیسهای واقعی، رابطهی چندبهچند معمولاً با یک جدول واسط پیاده میشود، و پرسشی که سه یا چهار جدول را درگیر کند، اگر مسیر join درست بسته نشود، یا خطا میدهد یا بدتر، عددی که منطقی به نظر میرسد و غلط است. سوم، مقادیر. کاربر میگوید «شعبهی مشهد»، اما در ستون چیزی شبیه «مشهد - مرکزی» یا یک کد عددی ذخیره شده است. فیلتری که روی حدس نوشته شود، نتیجهی خالی یا ناقص میدهد.
چهارم، و خطرناکتر از بقیه: اعتماد. عددی که غلط باشد و با اطمینان نمایش داده شود، از «نمیدانم» بدتر است، چون کاربر پیش از کشف خطا بر پایهی آن تصمیم میگیرد. دربارهی همین منطق در مقالهی قرارداد «نمیدانم» در برابر توهم هوش مصنوعی بیشتر نوشتهایم.
دانابات هر کدام از این چهار نقطه را جداگانه هدف گرفته است. بیایید یکییکی ببینیم.
لایه معنایی: اول دیتابیس را بفهم، بعد جواب بده
بخش اول کار، Schema Explorer است. این بخش جدولها و رابطههای دیتابیس را خودکار کشف میکند و برای هر ستون یک توضیح فارسی میسازد. نتیجه، یک لایهی معنایی است که بین زبان کاربر و نامهای فنی دیتابیس مینشیند.
فرق این کار با «دادن اسکیما به مدل» چیست؟ مدل بهجای حدس زدن از روی amt_net یا ctr_dt، با توضیحی مثل «مبلغ خالص قرارداد» و «تاریخ انعقاد قرارداد» کار میکند. وقتی مدیر میپرسد «ارزش قراردادهای امسال»، سامانه از قبل میداند کدام ستون را باید دنبال کند.
فرض کنید دیتابیس شما یک جدول به اسم tbl_ctr و یک جدول tbl_vnd دارد. بدون لایهی معنایی، اینها دو رشتهی بیمعنیاند. با آن، میشوند «قراردادها» و «تامینکنندگان»، بههمراه توضیح هر ستونشان.
سوال سخت: چند جدول، یک جواب
سوالهای ساده را هر ابزاری جواب میدهد. سوالهایی که واقعاً وقت مدیران را میگیرند، چندجدولیاند. مثلاً:
«کدام پیمانکارها در شش ماه گذشته بیش از دو قرارداد با تاخیر داشتهاند و جمع جریمهی هرکدام چقدر بوده؟»
برای جواب این سوال، چند اتفاق باید با هم درست بیفتد. اول باید جدولهای درست انتخاب شوند. دانابات این انتخاب را با ترکیب سه چیز انجام میدهد: کلیدواژه، جستوجوی معنایی و مدل زبانی. هیچکدام تنها کافی نیست؛ کلیدواژه دقیق است اما سختگیر، معنایی منعطف است اما گاهی دور میزند، و مدل داور نهایی است.
بعد باید مسیر join بسته شود. سامانه این مسیر را خودکار پیدا میکند، حتی وقتی بین دو جدول یک جدول واسط چندبهچند قرار دارد. و در پایان، فیلترها باید روی مقادیر واقعی ستونها ساخته شوند. به این کار value-grounding میگویند: اگر کاربر بنویسد «مشهد»، سامانه مقادیر واقعی ستون شعبه را میبیند و فیلتر را با همان مقدار ذخیرهشده میسازد، نه با حدس.
نتیجه این است که «چند جدول» برای کاربر فقط یک جمله است؛ پیچیدگی join و فیلتر پشت صحنه میماند.
هر پرسش موفق، پرسش بعدی را بهتر میکند
دو سازوکار کوچک اما مهم هم در کار است. اولی اصلاح خودکار خطای کوئری است: اگر SQL تولیدشده هنگام اجرا خطا بدهد، سامانه خطا را میخواند و کوئری را اصلاح میکند، نه اینکه خطای فنی را جلوی مدیر بگذارد.
دومی few-shot خودتغذیه است. پرسشهای موفق به مخزن نمونهها اضافه میشوند، و کیفیت با استفاده بالا میرود. به بیان ساده، سامانه از سوالهایی که قبلاً درست جواب داده یاد میگیرد که سوالهای مشابه را چطور جواب دهد. در عمل یعنی سازمان شما بعد از چند ماه استفاده، دستیاری دارد که زبان خودِ شما را بهتر میفهمد، با اصطلاحات، اختصارها و شیوهی سوال پرسیدن همکارانتان.
یک عدد، یک تعریف: شاخصهای رسمی
این بخش شاید مهمترین قسمت برای اعتماد باشد. دو مدیر را تصور کنید که هر دو میپرسند «فروش خالص ماه گذشته چقدر بود؟» اگر هر بار SQL از نو تولید شود، احتمال دارد دو تعریف کمی متفاوت از «خالص» (با مرجوعی، بدون مرجوعی، با تخفیف نقدی) دو عدد متفاوت بدهد. دعوای بعدی در جلسه، بر سر عدد خواهد بود، نه تصمیم.
راهحل دانابات، Metric Registry یا ثبت شاخصهای رسمی است. برای سوالهای پرتکرار، تعریف قطعی شاخص یکبار ثبت میشود و جواب بدون تولید لحظهای SQL، قطعی و سریع میآید. هر کس هر زمان بپرسد، همان عدد را میبیند.
یک نکتهی صادقانه: این تعریفها را سامانه از آسمان نمیآورد. اینکه «فروش خالص» در سازمان شما یعنی چه، تصمیمی است که واحد مالی شما باید بگیرد. ابزار فقط تضمین میکند که آن تصمیم یکبار گرفته شود و همهجا یکسان اجرا شود.
دسترسی: تا سطح جدول و ستون
سوال بعدی هر مدیر امنیت روشن است: اگر هر کس بتواند از دیتابیس بپرسد، حقوق همکاران چه میشود؟
کنترل دسترسی NL2SQL تا سطح جدول و ستون پیش میرود. میتوان تعیین کرد که یک نقش اصلاً جدول حقوق را نبیند، یا جدول مشتریان را ببیند اما ستون شمارهی تماس را نه. این همان اصلی است که در کل دانابات حاکم است: سازمان قواعد دسترسی را تعیین میکند و دانابات آنها را اجرا میکند. و چون سامانه فقطخواندنی است، بدترین سناریوی خطا هم «نمایش دادهی نادرست» است، نه «تغییر یا حذف داده».
دربارهی محل پردازش هم باید دقیق بود. در استقرار On-Prem با مدل زبانی محلی، دادهها از شبکهی سازمان خارج نمیشوند. اگر سازمان آگاهانه مدل ابری انتخاب کند، این یک مبادلهی دقت و محلیماندن داده است، و تصمیم آن با خود سازمان است.