
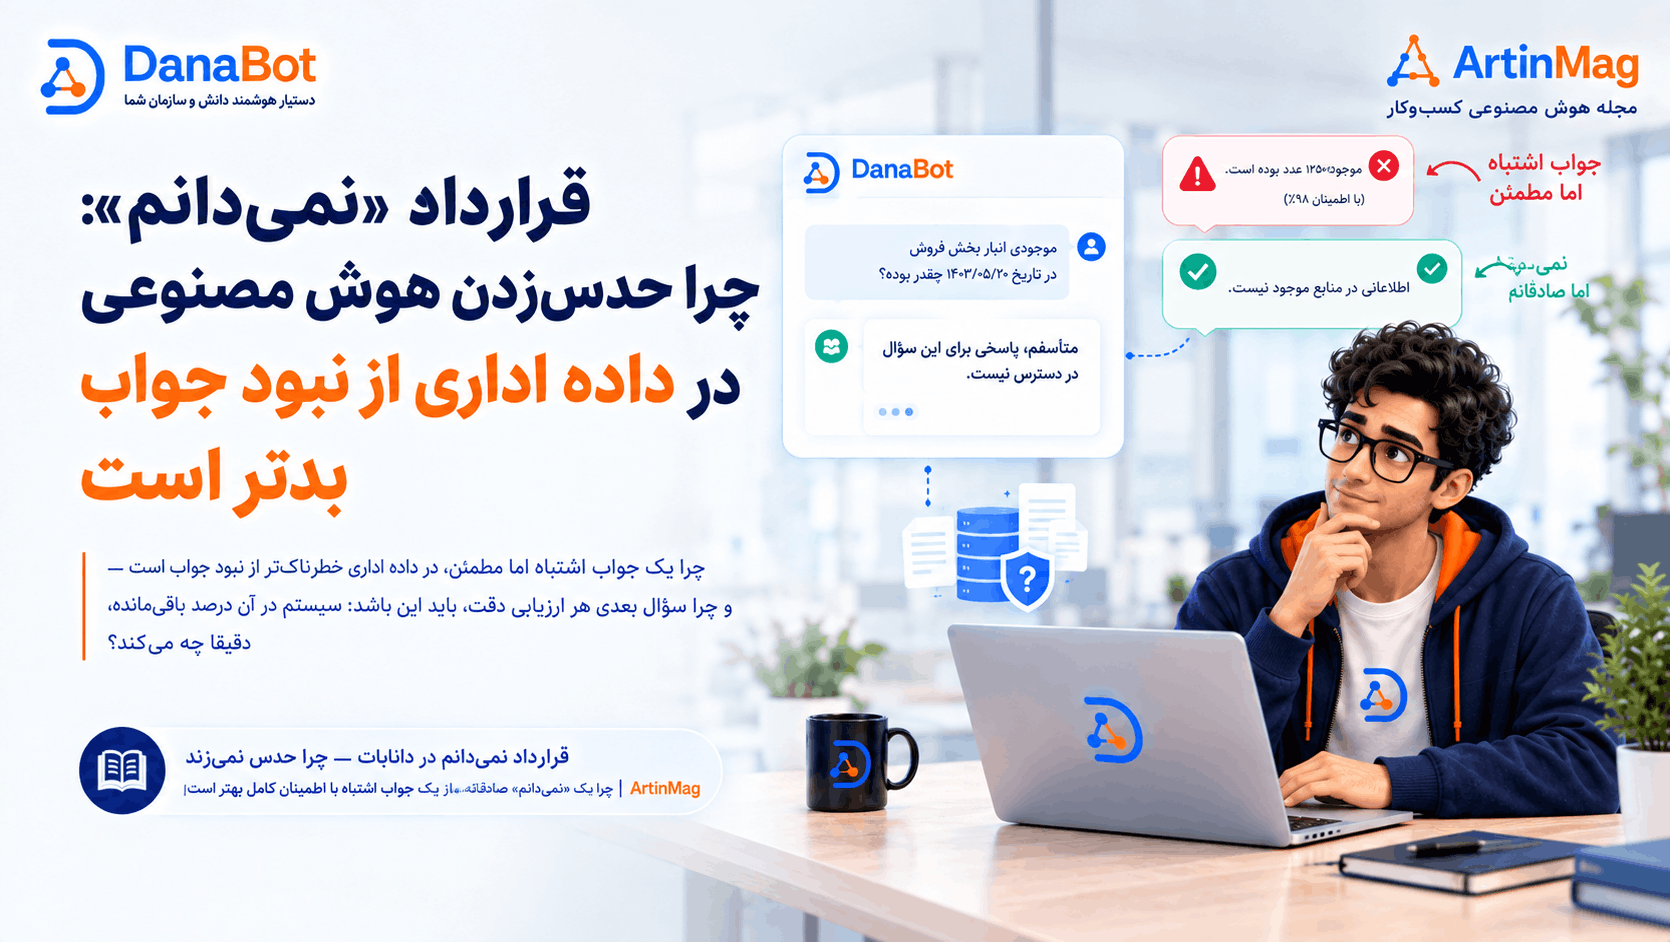
سوالی که بعد از دیدن روش ارزیابی دقت مطرح میشود
در مقاله قبلی دیدیم که دقت باید اندازهگیری شود، نه ادعا. اما حتی یک سیستم با دقت اندازهگیریشده بالای ۹۰ درصد، یعنی در بخشی از موارد، جواب درست را ندارد. سؤال واقعاً مهم این است: در همان بخش باقیمانده، سیستم دقیقاً چه کار میکند؟
چرا یک جواب اشتباه، از نبود جواب خطرناکتر است
در داده اداری و سازمانی، یک جواب اشتباه ولی با لحن مطمئن، خطرناکتر از نبود جواب است. اگر سیستمی بگوید «نمیدانم»، کاربر میداند باید جای دیگری بگردد یا از همکار بپرسد. اما اگر سیستم با اطمینان یک تاریخ، یک رقم، یا یک بند قراردادی اشتباه اعلام کند، کاربر معمولاً همان را باور میکند و بر اساس آن تصمیم میگیرد — و اشتباه، تا وقتی که خیلی دیر شده، کشف نمیشود.
چه اتفاقی میافتد وقتی سیستمهای مختلف جواب را ندارند
سه رفتار متفاوت اینجا قابلمقایسه است. یک چتبات هوش مصنوعی عمومی، وقتی جواب دقیق را ندارد، معمولاً بهجای اعتراف به این موضوع، یک جواب محتمل و قانعکننده میسازد — همان چیزی که در ادبیات فنی «توهم» نامیده میشود. یک جستوجوی سنتی داخل سامانه، وقتی چیزی پیدا نمیکند، صرفاً یک فهرست خالی برمیگرداند — صادق است، اما کمکی هم نمیکند. رفتار سوم، این است که سیستم صریح بگوید «یافت نشد» — هم صادق و هم روشن درباره اینکه چرا هیچ نتیجهای وجود ندارد.
قرارداد «نمیدانم» دقیقاً چیست
این قرارداد، یک تعهد طراحیشده است: اگر دانابات مطمئن نباشد، حدس نمیزند — و همین را صریح اعلام میکند. این تصمیم، نتیجه یک باور ساده است: در داده اداری، جواب اشتباه، از نبود جواب بدتر است. این یعنی سیستم، بهجای بهینهسازی برای «همیشه یک جواب دادن»، برای «هرگز جواب نادرست ندادن» طراحی شده است — که یک انتخاب معماری آگاهانه است، نه یک محدودیت فنی که بعداً کشف شده باشد.
چرا این قرارداد، اعتماد بلندمدت میسازد
سیستمی که گاهی صادقانه میگوید نمیداند، در بلندمدت قابلاعتمادتر از سیستمی است که همیشه یک جواب میدهد اما گاهی آن جواب اشتباه است. دلیلش ساده است: وقتی کاربر یاد بگیرد که هر جوابی که سیستم میدهد — بدون استثنا — واقعاً از یک سند یا داده واقعی آمده، دیگر نیازی به دوبارهچککردن هر پاسخ ندارد. این اعتماد، ارزشی بهمراتب بیشتر از چند درصد دقت بالاتر در ظاهر دارد.