
سوالی که بعد از حاکمیت داده مطرح میشود
در مقاله قبلی درباره ABAC و حاکمیت داده دیدیم که کنترل دسترسی چطور تضمین میشود. اما یک سؤال دیگر هم در فرایند ارزیابی هر سازمان بزرگ باید پرسیده شود: از کجا معلوم پاسخهایی که این سیستم میدهد، واقعاً درست است؟
چرا اکثر ادعاهای دقت در بازار هوش مصنوعی قابلاعتماد نیستند
تقریباً هر فروشنده ابزار هوش مصنوعی، یک عدد دقت بالا اعلام میکند — «۹۰ درصد دقیق»، «۹۵ درصد رضایت». اما وقتی از آنها میپرسید این عدد از کجا آمده، اکثر اوقات یا جوابی نیست، یا پاسخ مبهم است. سؤال درست این نیست که «چند درصد دقیق است»؛ سؤال درست این است که «این عدد را چطور و روی چه دادهای اندازه گرفتهاید؟»
Golden Set چیست و چرا پایه اندازهگیری واقعی است
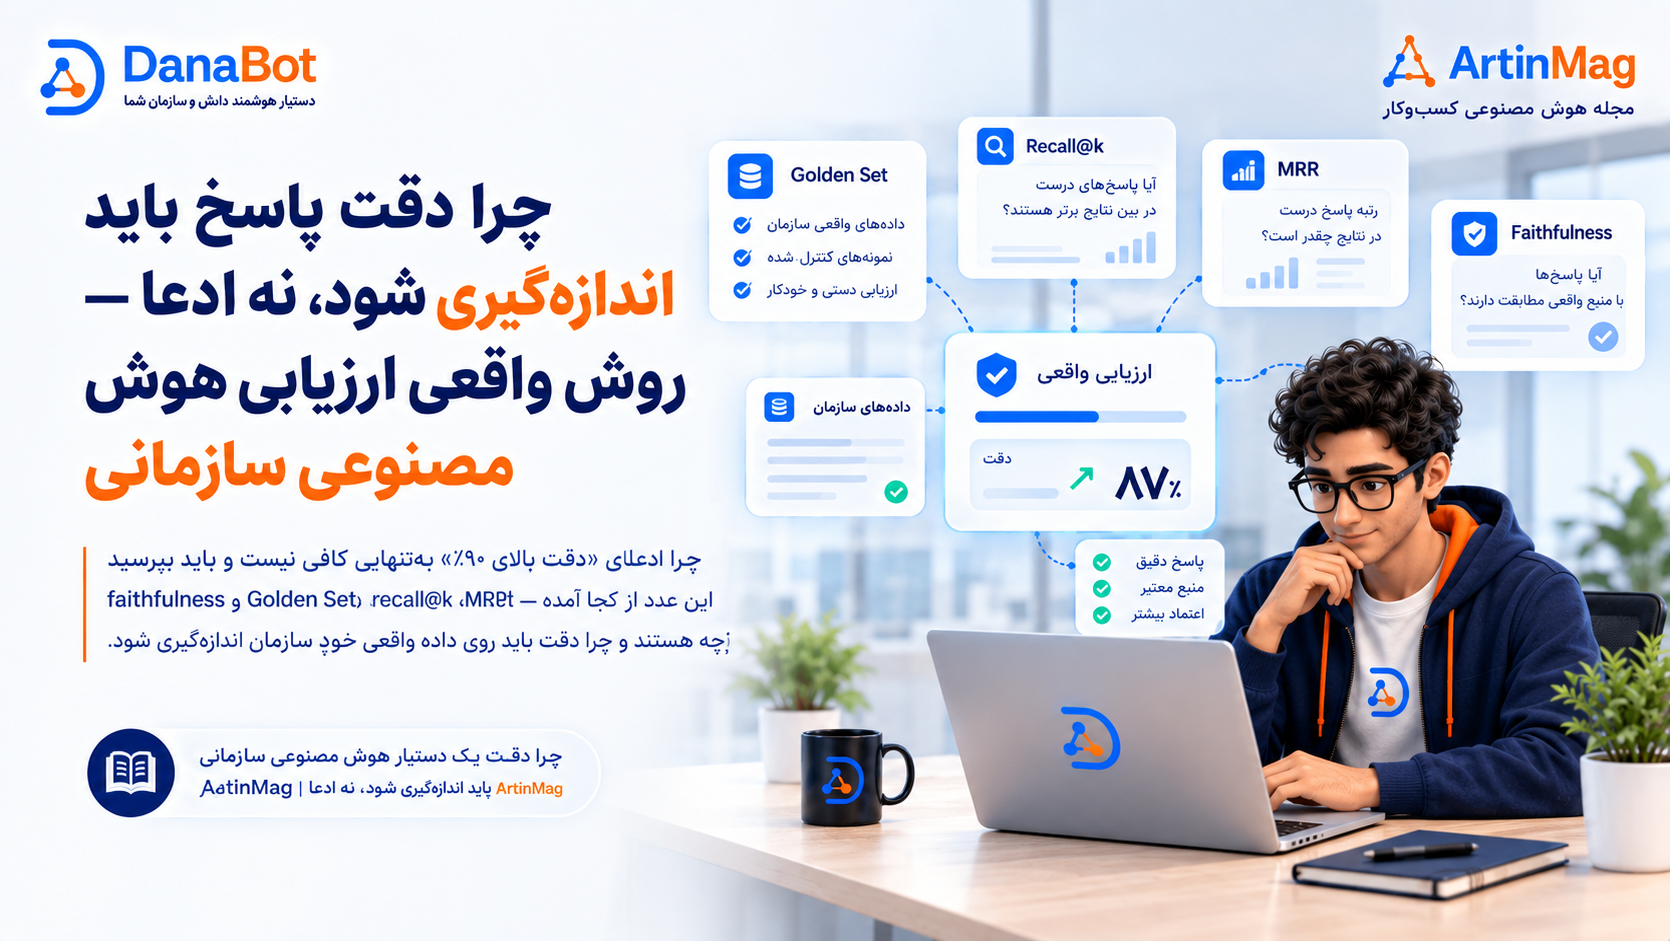
Golden Set، مجموعهای از سؤالات واقعی بههمراه پاسخ درست تأییدشده است — نه سؤالات عمومی و آزمایشی، بلکه دقیقاً همان نوع سؤالی که کاربران واقعی یک سازمان میپرسند، با پاسخ درستی که از قبل مشخص شده. وقتی یک سیستم روی همین مجموعه تست میشود، عدد دقتی که بهدست میآید، معنای واقعی دارد — چون معیار مقایسه، واقعیت است، نه یک حدس یا یک نظرسنجی رضایت کلی.
سه معیار: recall@k، MRR، و faithfulness
اندازهگیری دقیقتر، از سه زاویه انجام میشود. Recall@k، نشان میدهد از میان چند نتیجه بازیابیشده، آیا پاسخ درست واقعاً در آنها وجود دارد یا نه. MRR (میانگین معکوس رتبه)، نشان میدهد وقتی پاسخ درست پیدا میشود، معمولاً در چه جایگاهی از نتایج قرار دارد — نتیجه اول یا نتیجه دهم. Faithfulness، شاید مهمترین معیار باشد: آیا پاسخ نهایی، واقعاً بر اساس همان سندی است که به آن استناد شده، یا سیستم چیزی فراتر از آن سند اضافه کرده است.
چرا این عدد فقط یکبار گرفته نمیشود
یک نکته مهم این است که این ارزیابی، یک تست یکباره در ابتدای کار نیست. هر تغییری که بعداً در موتور سیستم اعمال شود، باید دوباره از همان Golden Set عبور کند. این یعنی هیچ بهروزرسانی یا تنظیم جدیدی، بدون اطمینان از اینکه دقت افت نکرده، وارد نسخه نهایی نمیشود — یک تست رگرسیون مداوم، نه یک گواهی یکبارمصرف.