
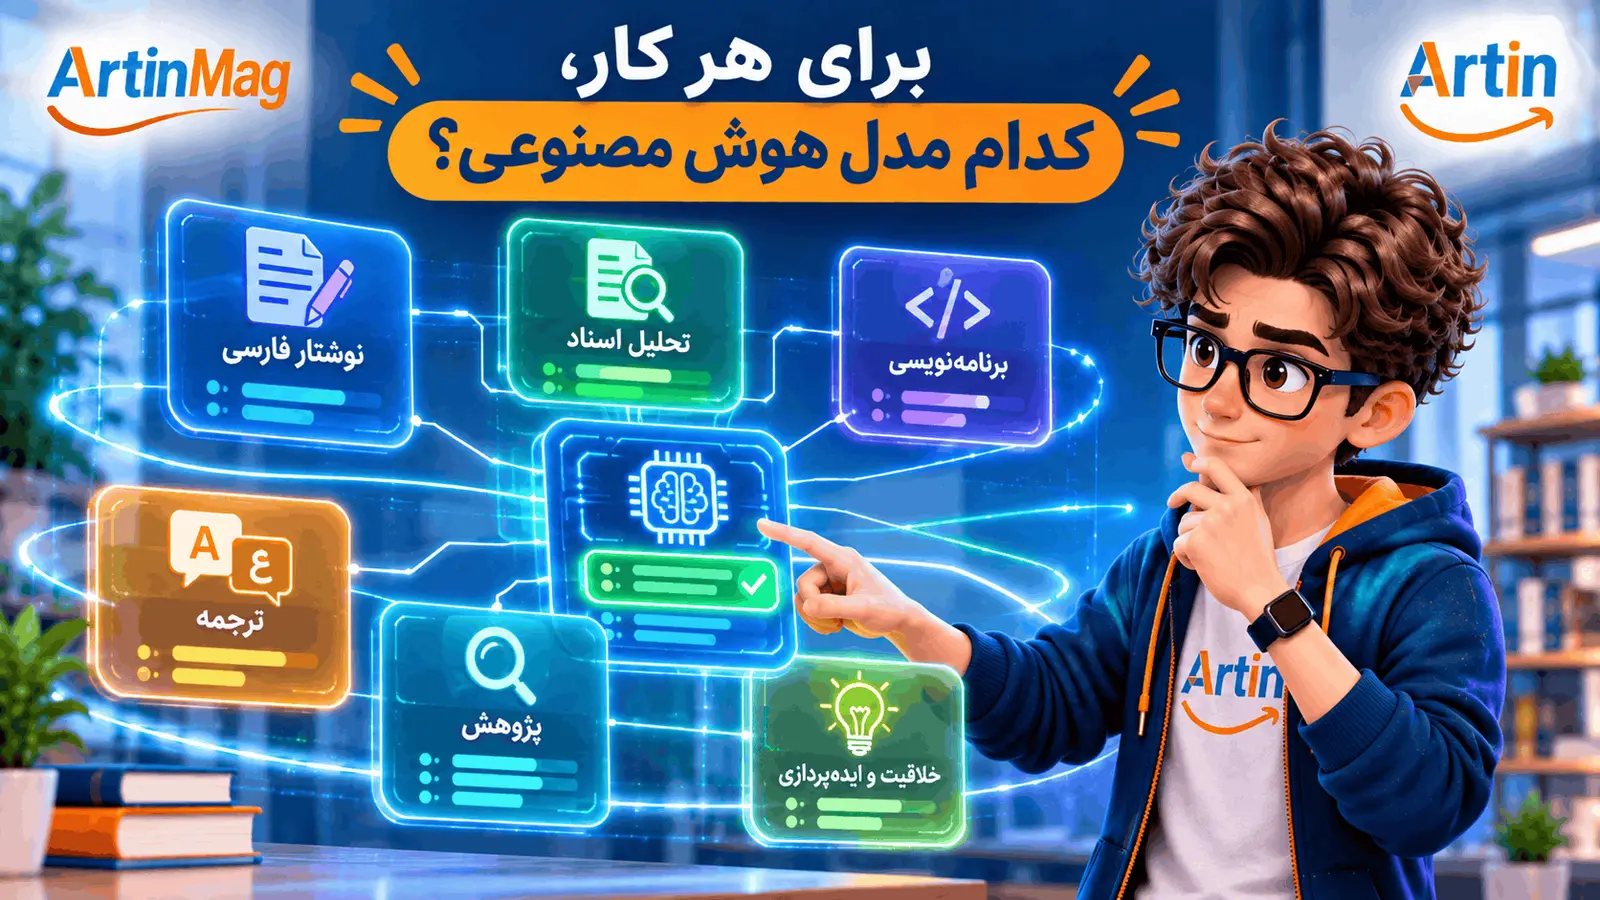
«بهترین مدل کدام است؟»
این پرسش بیشتر از هر پرسش دیگری دربارهٔ هوش مصنوعی پرسیده میشود و جوابش معمولاً یک اسم است. مشکل این جواب دو چیز است. اول، رتبهبندیها بیشتر روی آزمونهای انگلیسی ساخته میشوند و نمیگویند مدلی که در آن آزمون اول شده، در نوشتن یک نامهٔ رسمی فارسی هم خوب است یا نه. دوم، جوابها زود کهنه میشوند. مدلی که امروز در یک کار خوب است، ماه بعد با نسخهٔ تازه تغییر میکند.
در تلنت ای آی میتوان بین چند مدل جابهجا شد، و همین امکان پرسش را جدیتر میکند: حالا که انتخاب دارید، کدام را برای کدام کار به کار ببرید؟ ما در این مقاله یک رتبهبندی نمیدهیم، چون نمیتوانیم ادعایی بدهیم که یک ماه بعد هنوز درست باشد. بهجای آن یک آزمون ساده میدهیم که خودتان با کارهای واقعیتان انجام دهید و هر وقت مدلها عوض شدند تکرارش کنید.
چرا رتبهبندی عمومی کافی نیست؟
چند دلیل هست. اول، کار فارسی شما خاص است: نامهٔ اداری با لحن رسمی، خلاصهکردن یک گزارش مالی، ترجمهٔ بین فارسی و انگلیسی یا بازنویسی یک متن با نیمفاصلهها و نشانهگذاری درست. هیچ رتبهبندی عمومی دقیقاً همین کارها را نمیسنجد. دوم، پرسش شما هم مهم است. مدلی که با یک پرسش دقیق خوب جواب میدهد، با پرسش مبهم ممکن است ضعیف باشد، و برعکس. سوم، معیار شما با معیار آزمونها فرق دارد: شاید برای شما سرعت و هزینه مهمتر از آخرین درصد دقت باشد.
و یک دلیل چهارم هم هست: همان مدل در دو بار پرسش یکسان ممکن است دو جواب متفاوت بدهد. پس نتیجهٔ یک بار امتحان کردن چیزی را ثابت نمیکند.
آزمون سهسؤالی
سه کار انتخاب کنید که واقعاً در هفته انجام میدهید و جواب درستش را میدانید. مثلاً یک کار نوشتاری مثل پیشنویس یک نامهٔ رسمی، یک کار تحلیلی مثل محاسبه یا مقایسه با چند شرط، و یک کار تبدیلی مثل خلاصهکردن یک متن بلند یا ترجمه. دلیل انتخاب این سه این است که مهارتهای متفاوتی را میسنجند و ممکن است هر مدل در یکی بهتر باشد.
برای هر کار یک پرسش دقیق بنویسید، با همهٔ اطلاعات لازم، و همان پرسش را بدون تغییر به هر مدل بدهید. اگر پرسش را برای هر مدل کمی عوض کنید، دیگر نمیدانید تفاوت از مدل بود یا از پرسش. نتیجه را در یک برگه بنویسید. ما از پنج معیار استفاده میکنیم: درستی محتوا، روانی و دستور فارسی، رعایت خواستههای شما مثل طول و لحن، سرعت و هزینه.
سناریو اول: نوشتن رسمی فارسی
دبیر یک مجموعهٔ آموزشی را تصور کنید که چند نامهٔ رسمی در هفته مینویسد. از سه مدل میخواهد نامهای برای دعوت از اعضای هیئت امنا بنویسند، با لحن مؤدب، حداکثر دو بند و ذکر تاریخ و مکان جلسه. تفاوتها معمولاً در جزئیات دیده میشود: یکی لحن را بیش از حد تشریفاتی میکند، یکی تاریخ را جابهجا مینویسد و یکی طول را رعایت نمیکند.
درس این سناریو این است که برای نوشتن فارسی «روانی» بهتنهایی کافی نیست. یک متن میتواند بسیار روان و در عین حال غلط باشد. معیار درستی را جدا از معیار روانی بسنجید. دربارهٔ نوشتن نامهٔ رسمی با کمک دستیار، نامهٔ اداری، صورتجلسه و گزارش با هوش مصنوعی را ببینید.
سناریو دوم: تحلیل و محاسبه
کارشناس مالی را در نظر بگیرید که میخواهد بین دو برنامهٔ پرداخت یکی را انتخاب کند. اطلاعات را کامل به هر مدل میدهد و جواب خودش را از قبل با یک جدول Excel حساب کرده است. حالا میتواند ببیند هر مدل به جواب درست رسید یا نه، و مهمتر، اگر نرسید، کجا اشتباه کرد.
در این کار «درستی» تنها معیار مهم است و جواب مرجع شما داور است. اگر مدلی با اطمینان جواب غلط داد، آن خطر را در برگه یادداشت کنید، نه فقط نتیجه را. همینجا دو کلید جستوجوی وب و تفکر عمیق هم وارد میشوند؛ در مقالهٔ مربوط به آنها آمده که تفکر عمیق دقت استدلال را بالا میبرد و برای همین آزمون تحلیلی بهتر است هر مدل را یک بار با و یک بار بدون آن امتحان کنید.
سناریو سوم: خلاصه و ترجمه
سومین کار تبدیلی است: خلاصه کردن یک گزارش دهصفحهای یا ترجمهٔ یک متن فنی. دانشجوی تحصیلات تکمیلی را تصور کنید که چکیدهٔ مقالهاش را از فارسی به انگلیسی ترجمه میکند. اصطلاحهای تخصصی، ساختار جمله و حفظ معنا معیارهای اصلیاند.
برای این کار یک ترفند خوب هست: مدل را «کور» مقایسه کنید. جوابها را بدون اسم مدل کنار هم بگذارید یا از همکاری بخواهید بدون دانستن اسمها نمره بدهد. شهرت یک نام روی قضاوت ما اثر میگذارد و این اثر را فقط با پنهانکردن نام میشود کم کرد. نتیجه را در برگهٔ امتیازدهی بنویسید.