دانشی که هیچجا نوشته نشده
در هر سازمانی جملهای وجود دارد که همه میشناسند: «این را از حسین بپرس.» حسین هیچ سندی ننوشته است. او فقط بیست سال است که میداند وقتی دستگاه فلان صدا را میدهد مشکل از کدام قطعه است، یا فلان مشتری را باید چطور راضی کرد، یا فلان خطای سامانهی مالی را با چه ترتیبی باید برطرف کرد. تا وقتی حسین هست، این دانش کار میکند. روزی که بازنشسته شود یا به شرکت دیگری برود، آن دانش هم با او میرود.
این همان چیزی است که در ادبیات مدیریت دانش به آن دانش ضمنی میگویند: دانشی که در ذهن آدمها و عادتهای کاریشان زندگی میکند و جایی ثبت نشده است. هیچ دانشنامهای، هر چقدر هوشمند، نمیتواند چیزی را پیدا کند که هرگز نوشته نشده است.
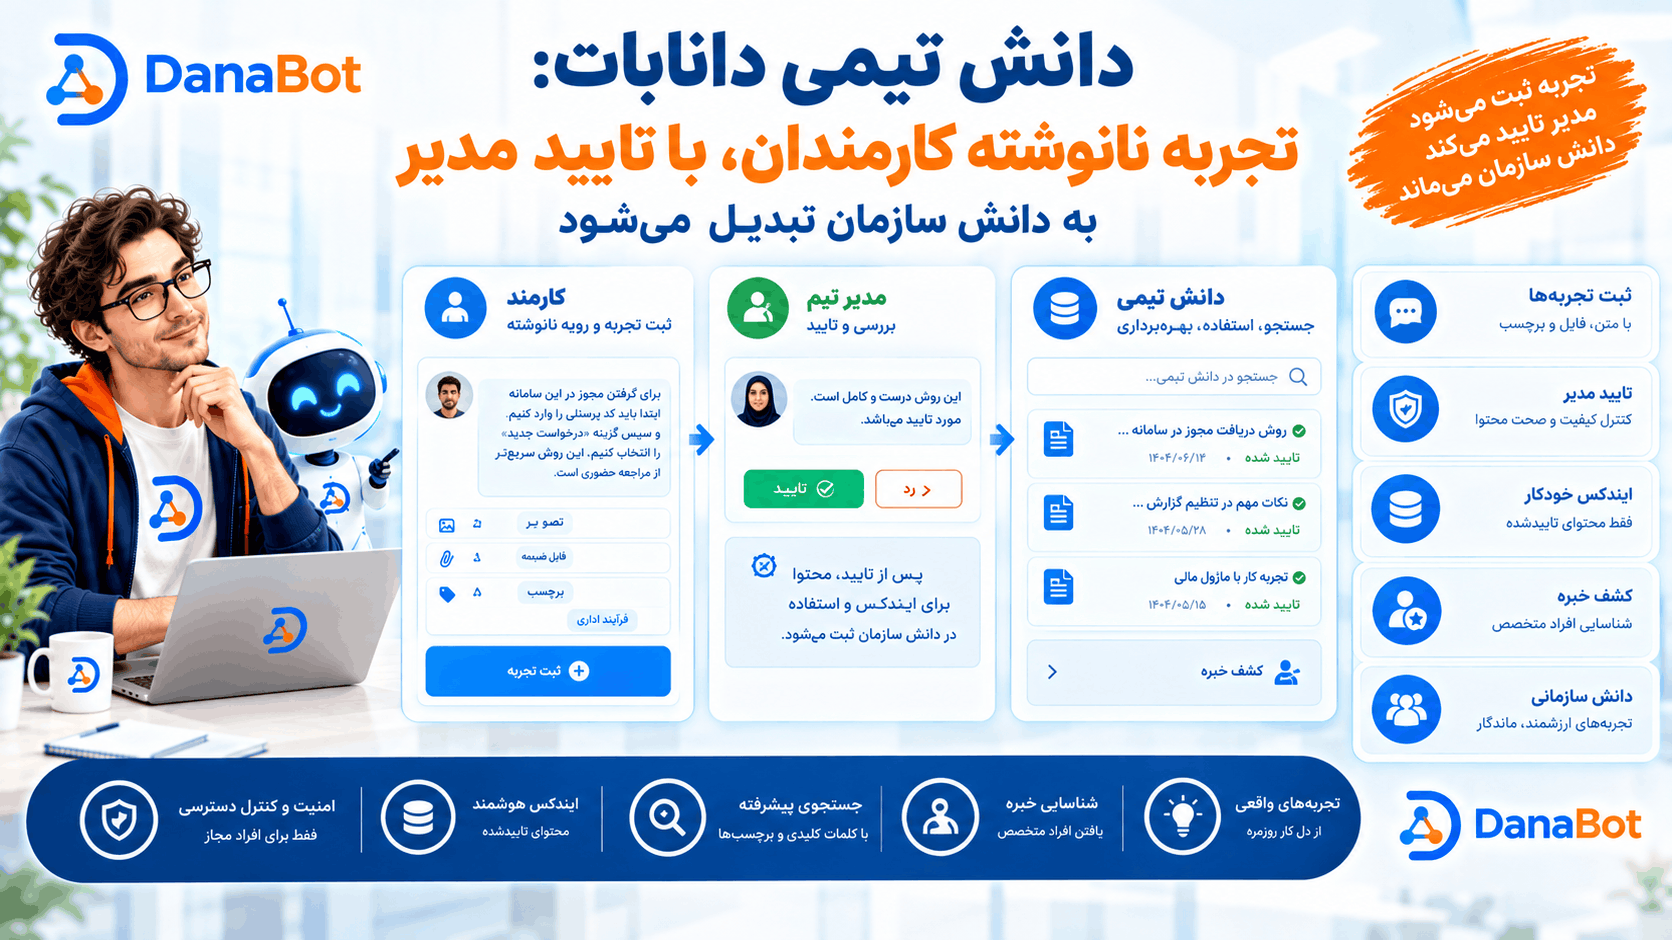
ماژول «دانش تیمی» در دانابات برای همین مسئله ساخته شده است: راهی ساختاریافته برای اینکه تجربهی نانوشته، قبل از رفتن آدمها، وارد دانش سازمان شود.
چرا آپلود فایل کافی نیست
دانشنامهی سازمانی بر پایهی سند کار میکند: فایلی آپلود میشود، ایندکس میشود، و پرسش و پاسخ روی آن انجام میشود. این برای آییننامه، بخشنامه و قرارداد عالی است. اما تجربهی حسین سند نیست. نه فایلی دارد که آپلود شود و نه کسی وقت میکند آن را در قالب یک سند رسمی بنویسد.
مشکل دوم عمیقتر است: حتی اگر حسین بنویسد، چه کسی تضمین میکند آنچه نوشته درست است؟ تجربهی شخصی، مفید است اما همیشه قابلتعمیم نیست. ممکن است برای یک مدل قدیمی دستگاه درست باشد و برای مدل جدید نه. اگر هر چیزی که هر کسی مینویسد مستقیم وارد دانش رسمی شود، دانشنامهی شما کمکم از یک مرجع قابلاتکا به یک انبار حدسهای خوب و بد تبدیل میشود.
دانش تیمی دقیقاً چه میکند
سازوکار ساده است و سه گام دارد. کارمند تجربه یا رویهی نانوشته را ثبت میکند. مدیر تیم آن را بررسی میکند و میتواند ویرایش، تایید یا رد کند. و فقط محتوای تاییدشده ایندکس میشود و در پاسخها ظاهر میشود.
نکتهی اصلی در همین گام سوم است. هر چیزی که ثبت شود، وارد پاسخها نمیشود؛ فقط آنچه از دروازهی تایید گذشته باشد. به این ترتیب، سازمان هم تجربهی نانوشته را جمع میکند و هم کیفیت دانش رسمی را حفظ میکند.
اگر مقالهی دستیار من در دانابات را خوانده باشید، همین منطق را دیدهاید: دانش شخصی خودکار به دانش سازمان تبدیل نمیشود، و دانش تیمی همان دروازهای است که این گذار را کنترل میکند.
تیم بهعنوان یک ماژول مستقل
در دانابات تیمها یک ماژول مستقلاند و از دانشنامه جدا هستند. این جداسازی یک نتیجهی عملی دارد: نقش داور با نقش مدیر اعضا یکی نیست.
یعنی کسی که تعیین میکند چه کسانی عضو تیماند، لزوماً همان کسی نیست که صحت محتوا را تایید میکند. این تفکیک در سازمانهای واقعی اهمیت دارد. مدیر اداری یک واحد ممکن است عضوها را تعیین کند، اما دربارهی درستی یک رویهی فنی، فقط سرپرست فنی صلاحیت قضاوت دارد. دانابات این دو نقش را از هم جدا نگه میدارد.
تعریف خبره و کشف خبره
بخشی از دانش هرگز نوشته نمیشود، اما میشود دانست که چه کسی آن را دارد. دانش تیمی دو امکان برای این کار دارد.
اولی تعریف خبره است. برای هر فایل میتوان مشخص کرد که خبرهی آن موضوع کیست، یک کاربر مشخص یا یک سِمت. وقتی کسی دربارهی آن موضوع سوال دارد، میداند به چه کسی مراجعه کند. دومی کشف خبره بر پایهی فعالیت است: سامانه از روی فعالیت کاربران در سامانه، پیشنهاد میدهد چه کسی در یک حوزهی مشخص فعالتر است.
یک نکتهی صادقانه: فعالیت معیار قطعی تخصص نیست. کسی که زیاد در یک حوزه ثبت و پرسوجو میکند لزوماً خبرهتر از کسی نیست که کمحرف است اما درست میداند. کشف خبره یک سرنخ است، نه حکم. تصمیم نهایی دربارهی اینکه چه کسی خبرهی رسمی است، باید دست آدمها بماند.
یادداشت شخصی روی اسناد
یک امکان کوچک اما کاربردی هم هست: کارمند میتواند روی اسناد یادداشت شخصی بگذارد. این همان لایهای است که تجربهی روزمره، مثل «این بند در عمل اینطور اجرا میشود»، را کنار سند نگه میدارد. اگر یادداشتی ارزش مشترک داشته باشد، کارمند میتواند آن را جداگانه بهعنوان یک تجربه ثبت کند تا از دروازهی تایید عبور کند.
یک صف تایید، نه دو صف
دانابات ماژول دیگری هم دارد، دانشکاوی، که از تماسهای ضبطشده و گفتگوهای ارجاعشده به اپراتور، «کاندیدای دانش» استخراج میکند. سوال طبیعی این است: آیا این کاندیدها یک صف تایید جدا دارند؟
پاسخ خیر است. کاندیداهای دانشکاوی از همین صف دانش تیمی عبور میکنند. دو صف تایید وجود ندارد، و این عمدی است. اگر دو مسیر تایید وجود داشت، هر کدام قواعد و داور خودش را پیدا میکرد و دانش رسمی از دو مرجع متفاوت میآمد. یک صف، یک استاندارد کیفیت را تضمین میکند. دانشکاوی خودش به صورت پیشفرض خاموش است و نیاز به فعالسازی دارد.
این ماژول چه چیزی را عوض میکند و چه چیزی را نه
شاید بپرسید: ما میتوانیم از کارمندان بخواهیم تجربههایشان را در یک فایل ورد بنویسند و در پوشهای مشترک بگذارند. فرق این کار با دانش تیمی چیست؟
فرق در سه چیز است. اول ساختار: ثبت، بررسی و تایید یک مسیر مشخص دارند و هر مورد جای تعیینشدهای در آن دارد، نه اینکه فایلها بینظم در پوشهها پخش شوند. دوم بازیابی: محتوای تاییدشده ایندکس میشود و کارمند دیگر بدون دانستن اینکه چنین فایلی وجود دارد، با یک سوال به آن میرسد. سوم کنترل کیفیت: فایل مشترک هر چیزی را بیواسطه میپذیرد، اما اینجا یک داور مسئول بین ثبت و دانش رسمی قرار دارد.
اما یک چیز را عوض نمیکند: اینکه کسی باید تجربهاش را بنویسد. ابزار بهتر، انگیزهی ثبت را خودکار نمیسازد. سازمانی که میخواهد از این ماژول نتیجه بگیرد، باید همزمان به این فکر کند که چرا حسین باید ده دقیقه از وقتش را برای نوشتن یک رویه صرف کند. این سوال فنی نیست؛ سوال مدیریتی است.
سه سناریو از یک سازمان معمولی
اینها نمونهی مشتریان واقعی نیستند؛ سناریوهاییاند که نشان میدهند این ماژول در عمل چه شکلی پیدا میکند.
واحد نگهداری و تعمیرات. تکنسین ارشدی که نزدیک بازنشستگی است، رویهی عیبیابی یک دستگاه را ثبت میکند: «اگر دستگاه پس از راهاندازی صبح فلان رفتار را نشان داد، اول فلان را بررسی کنید.» سرپرست فنی آن را بازبینی میکند، یک نکته را اصلاح میکند و تایید میکند. از فردا، تکنسین جوان هر وقت بپرسد، همان رویه را با ارجاع به منبعش میبیند. حسین دیگر تنها مرجع نیست.
پشتیبانی مشتری. یک کارشناس باتجربه میداند فلان نوع شکایت معمولاً از کدام علت پنهان میآید. این را ثبت میکند. مدیر تیم بررسی میکند و میبیند یک بخش قدیمی است و رد میکند، بخش دیگر درست است و تایید میکند. نتیجه این است که فقط بخش درست وارد پاسخها میشود و دانش قدیمی، که میتوانست گمراهکننده باشد، وارد نمیشود.
واحد مالی. در پایان سال، یک حسابدار ارشد یادداشتهایی دارد دربارهی اینکه چرا فلان تصمیم حسابداری گرفته شد. اینها سند رسمی نیستند اما برای سال بعد ارزشمندند. با ثبت در دانش تیمی و تایید مدیر مالی، این دلایل جایی پیدا میکنند که حسابدار سال بعد بتواند آن را پیدا کند.
در هر سه سناریو، الگو یکی است: ثبت آسان، تایید آگاهانه، و پاسخهای بعدی با منبع مشخص.