چت بات

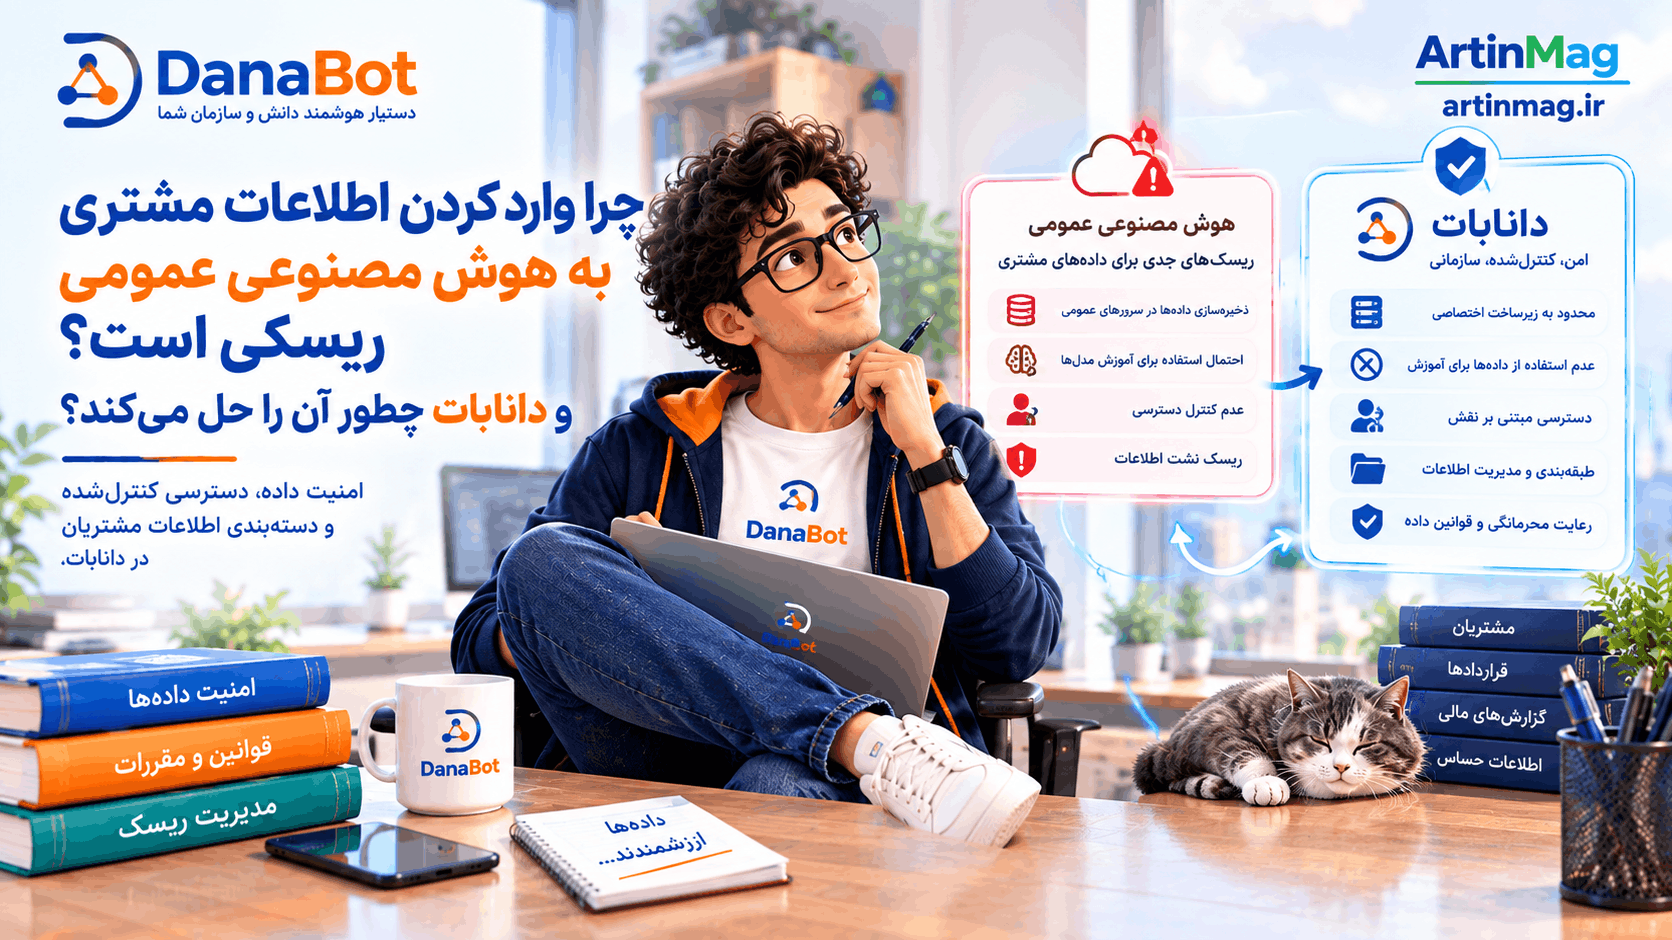
چرا وارد‌کردن اطلاعات مشتری به هوش مصنوعی عمومی ریسکی است و دانابات چطور آن را حل می‌کند؟

چرا ریسک اصلی هوش مصنوعی در شرکت‌های خدماتی کوچک، نه خودِ فناوری بلکه نبود قانون روشن برای داده است — و چطور دانابات با دسته‌بندی و دسترسی کنترل‌شده، این ریسک را حل می‌کند.

م
مرتضی علیزاده
4 دقیقه مطالعه
۳۳ بازدید
ریسک ورود اطلاعات مشتری به هوش مصنوعی عمومی و راه‌حل دانابات
چرا کنترل دسترسی به داده، مهم‌تر از خودِ ابزار هوش مصنوعی است | ArtinMag
فهرست مطالب (8 بخش)

سوالی که بعد از دو صنف قبلی مطرح می‌شود

در راه‌اندازی دانابات برای دفتر وکالت و شرکت حسابداری، هر دو بار به یک نگرانی مشترک اشاره کردیم: محرمانگی و تعارض منافع. این نگرانی، آن‌قدر مهم است که ارزش یک مقاله مستقل را دارد — چون احتمالاً اولین سؤالی است که در ذهن هر مالک شرکت خدماتی کوچک، وقتی اسم «هوش مصنوعی» می‌آید، شکل می‌گیرد.

ریسک واقعی، خودِ هوش مصنوعی نیست؛ نبود قانون روشن برای داده است

طبق اظهارنظر یک متخصص امنیت داده که به‌تازگی درباره پیاده‌سازی هوش مصنوعی در شرکت‌ها صحبت کرده، خطر اصلی، ابزار هوش مصنوعی نیست، بلکه نبود قوانین شفاف درباره نحوه کار با داده است. وقتی یک کارمند، بدون چارچوب مشخص، بخشی از قرارداد، پرونده مشتری، یا صورت مالی را در یک سرویس هوش مصنوعی عمومی وارد می‌کند، شرکت عملاً کنترل خودش را بر این‌که این اطلاعات کجا ذخیره می‌شود و چه کسی به آن دسترسی دارد، از دست می‌دهد.

چه اتفاقی می‌افتد وقتی داده مشتری بدون سیستم مشخص وارد یک ابزار عمومی می‌شود

این سناریو، دقیقاً همان چیزی است که در دفتر وکالت یا شرکت حسابداری، بیشترین آسیب را می‌زند: یک وکیل یا حسابدار، برای صرفه‌جویی در وقت، بخشی از پرونده یا سابقه مالی یک مشتری را در یک چت‌بات عمومی وارد می‌کند تا خلاصه یا تحلیلی بگیرد. این کار، نه از روی بی‌احتیاطی عمدی، بلکه از سر عادت و برای سرعت‌بخشیدن به کار انجام می‌شود — اما نتیجه‌اش، خروج داده محرمانه از کنترل شرکت است، بدون این‌که کسی متوجه شود.

قدم اول واقعی: دسته‌بندی داده، قبل از انتخاب هر ابزاری

پیش از راه‌اندازی هر سیستم هوش مصنوعی، توصیه یک متخصص امنیت داده این است که شرکت، اطلاعات خودش را به چند دسته تقسیم کند: اطلاعاتی که در دسترس عموم است، اطلاعات داخلی غیرحساس، و اطلاعات کاملاً محرمانه مشتری. برای یک شرکت خدماتی کوچک، این دسته‌بندی دقیقاً همان چیزی است که در مقاله دفتر وکالت به آن اشاره شد: متن قوانین و استانداردهای عمومی، در یک دسته؛ سابقه پرونده و اطلاعات مالی مشتری، در دسته‌ای کاملاً متفاوت با قوانین دسترسی سخت‌گیرانه‌تر.

چرا این همان طراحی‌ای است که در مقالات قبلی دیدیم

نکته مهم این‌جاست که راه‌حل این ریسک، دقیقاً همان اصلی است که در راه‌اندازی دانابات برای وکالت و حسابداری توضیح داده شد: دسترسی بر اساس ارتباط واقعی فرد با هر پرونده یا مشتری، نه دسترسی باز و یکسان برای همه. تفاوت اصلی دانابات با یک چت‌بات عمومی، دقیقاً همین‌جاست — دانابات از ابتدا برای محیطی طراحی شده که در آن، داده باید در کنترل شرکت بماند و دسترسی به هر بخش از آن، محدود و قابل‌ردیابی باشد.

تفاوت اصلی دانابات با وارد‌کردن مستقیم داده در ابزارهای عمومی

وقتی از یک ابزار هوش مصنوعی عمومی استفاده می‌کنید، داده‌ای که وارد می‌کنید، از کنترل شما خارج می‌شود و معمولاً هیچ سطح دسترسی یا ردیابی‌ای روی آن وجود ندارد. دانابات برعکس عمل می‌کند: داده در محیط کنترل‌شده شرکت باقی می‌ماند، دسترسی به هر بخش از آن بر اساس تخصیص واقعی فرد به پرونده یا مشتری تعریف می‌شود، و در هر لحظه مشخص است چه کسی به چه بخشی از دانش دسترسی داشته است.

اشتباهی که در این مرحله رایج است

رایج‌ترین اشتباه، این تصور است که یک هشدار شفاهی به کارمندان — «لطفاً اطلاعات محرمانه مشتری را در هوش مصنوعی وارد نکنید» — کافی است. طبق همان اظهارنظر متخصص امنیت داده، ریسک اصلی از نبود قانون روشن می‌آید، نه از بی‌توجهی کارمند؛ یعنی بدون یک سیستم واقعی که از ابتدا دسترسی و مسیر داده را کنترل کند، یک هشدار کلامی، دیر یا زود نادیده گرفته می‌شود.

جمع‌بندی

ریسک اصلی هوش مصنوعی برای یک شرکت خدماتی کوچک، خودِ فناوری نیست؛ نبود یک سیستم روشن برای دسته‌بندی داده و کنترل دسترسی است. راه‌حل، نه اجتناب کامل از هوش مصنوعی، و نه استفاده بی‌قاعده از ابزارهای عمومی، بلکه استفاده از یک سیستم که از ابتدا برای این کنترل طراحی شده باشد. برای دیدن این‌که دانابات چطور این کنترل را در عمل فراهم می‌کند، به دانابات سر بزنید.

تحلیل آرتین

اکثر محتوای فارسی درباره امنیت داده و هوش مصنوعی، کلی و سطح‌سازمان‌بزرگ است؛ این مقاله با اتصال مستقیم این نگرانی به رفتار واقعی و روزمره یک وکیل یا حسابدار (کپی‌کردن بخشی از پرونده در یک چت‌بات برای صرفه‌جویی در وقت)، این هشدار کلی را به یک ریسک ملموس و قابل‌فهم برای مخاطب شرکت خدماتی کوچک تبدیل می‌کند.

اثر بر کسب‌وکار

پرداختن مستقیم به این نگرانی، به‌جای نادیده‌گرفتن یا کم‌اهمیت جلوه‌دادن آن، اعتماد مخاطب شرکت خدماتی کوچک را جلب می‌کند و دانابات را به‌عنوان راه‌حلی برای همان ریسکی که مخاطب از قبل نگرانش بوده، معرفی می‌کند، نه یک ابزار جدید که خودش ریسک تازه‌ای اضافه می‌کند.

در ایران

با توجه به محدودیت دسترسی مستقیم به ابزارهای هوش مصنوعی خارجی در ایران و رواج استفاده غیررسمی از راه‌های جایگزین برای دسترسی به آن‌ها، ریسک ورود داده محرمانه به یک سرویس خارجی بدون هیچ کنترل یا شفافیتی درباره محل نگهداری داده، برای کسب‌وکار ایرانی حتی حادتر از بازارهای دیگر است.

سوالات متداول

چرا وارد‌کردن اطلاعات مشتری به هوش مصنوعی عمومی ریسکی است؟
چون وقتی داده بدون چارچوب مشخص وارد یک ابزار عمومی می‌شود، شرکت کنترل خود را بر محل ذخیره آن و دسترسی به آن از دست می‌دهد؛ ریسک اصلی از نبود قانون روشن برای داده می‌آید، نه از خودِ فناوری.
ریسک اصلی پیاده‌سازی هوش مصنوعی در شرکت‌های کوچک چیست؟
نبود قوانین شفاف درباره نحوه کار با داده — این‌که کارمند چه نوع اطلاعاتی را می‌تواند در چه ابزاری وارد کند — نه خودِ ابزار هوش مصنوعی.
چطور داده شرکت را قبل از استفاده از هوش مصنوعی دسته‌بندی کنیم؟
با تقسیم اطلاعات به سه دسته: اطلاعات در دسترس عموم، اطلاعات داخلی غیرحساس، و اطلاعات کاملاً محرمانه مشتری، و تعیین قوانین دسترسی متفاوت برای هرکدام.
تفاوت دانابات با وارد‌کردن مستقیم داده در ChatGPT چیست؟
دانابات داده را در محیط کنترل‌شده شرکت نگه می‌دارد و دسترسی به هر بخش را بر اساس تخصیص واقعی فرد به پرونده یا مشتری محدود و قابل‌ردیابی می‌کند؛ ابزارهای عمومی معمولاً چنین کنترلی ندارند.
چرا هشدار شفاهی به کارمندان درباره هوش مصنوعی کافی نیست؟
چون بدون یک سیستم واقعی که مسیر و دسترسی داده را از ابتدا کنترل کند، یک هشدار کلامی دیر یا زود نادیده گرفته می‌شود.

منابع

نظرات (0)

اطلاعات شما محفوظ می‌ماند و در نظرات بعدی نیاز به وارد کردن مجدد نیست

ک
نظر شما پس از تایید نمایش داده می‌شود

هنوز نظری ثبت نشده است

اولین نفری باشید که نظر می‌دهد!