
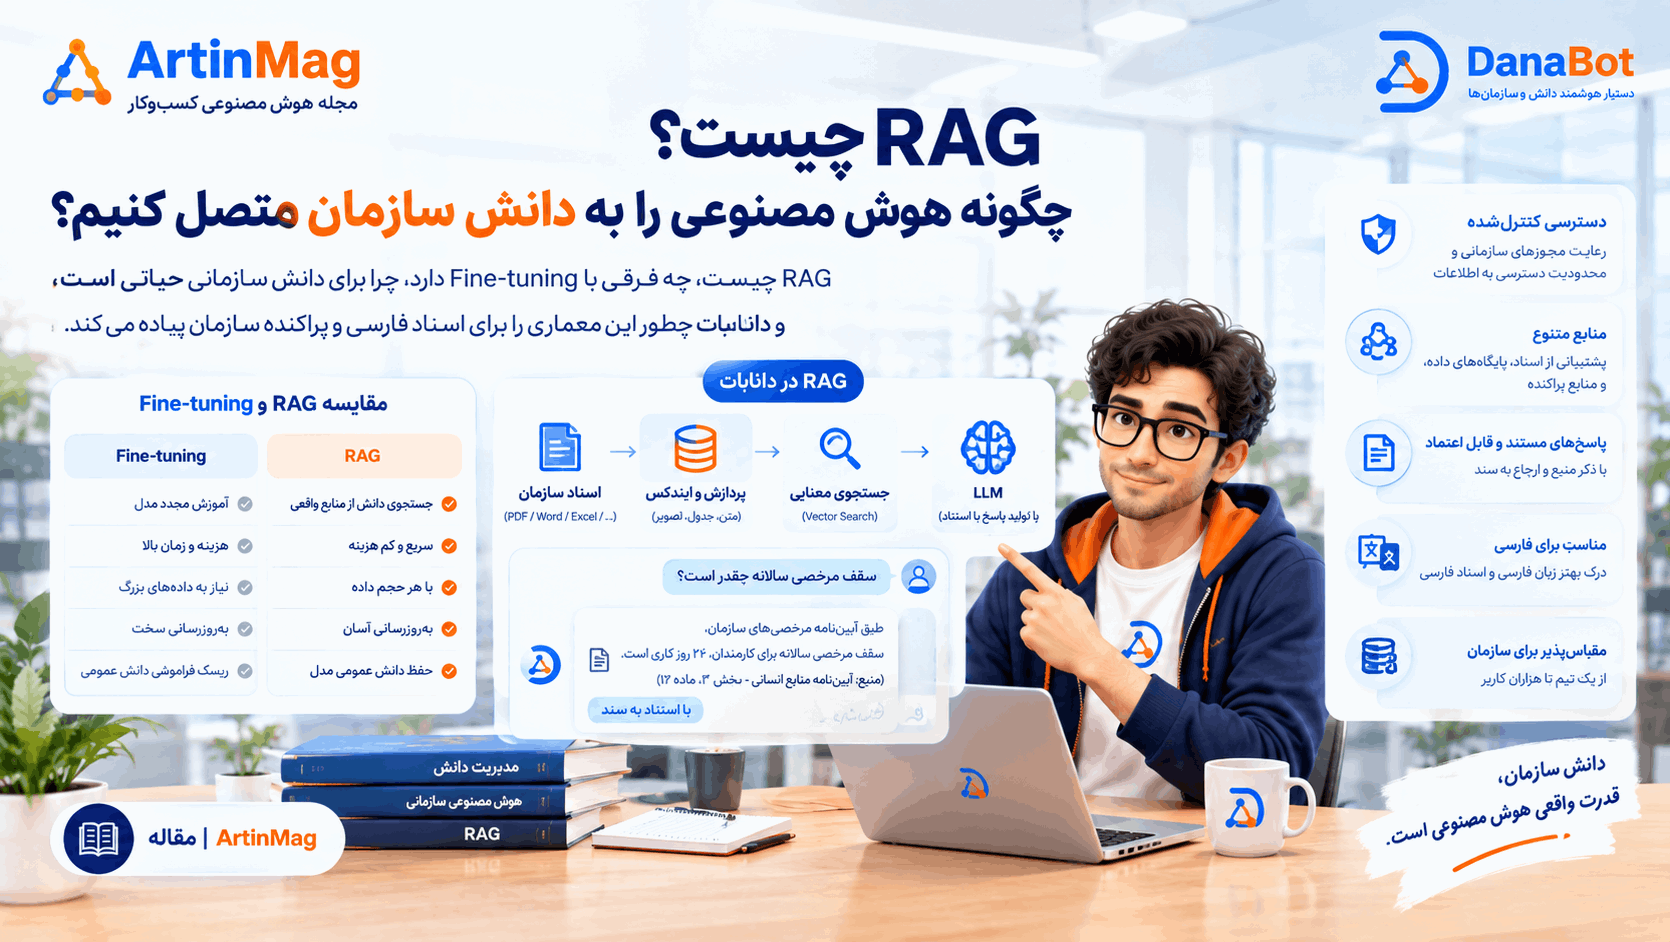
RAG چیست؟
RAG یا «تولید تقویتشده با بازیابی» (Retrieval-Augmented Generation)، روشی است که به مدلهای زبانی کمک میکند پیش از پاسخ دادن، ابتدا اطلاعات مرتبط را از یک منبع دانش بیرونی — مثل اسناد سازمان — بازیابی کنند، و سپس پاسخ را بر همان اساس بسازند. به زبان ساده: بهجای اینکه مدل از حافظه عمومی خودش حدس بزند، پاسخ را از سند واقعی شما میخواند.
چرا RAG برای دانش سازمانی حیاتی است
یک مدل زبانی عمومی، هرقدر هم قوی، چیزی از بخشنامه داخلی، آییننامه مرخصی، یا رویه اداری خاص سازمان شما نمیداند — مگر اینکه آن را از یک منبع مشخص بخواند. بدون RAG، مدل یا صادقانه میگوید نمیداند، یا بدتر، با اطمینان یک پاسخ نادرست میسازد (که به آن Hallucination گفته میشود). RAG این ریسک را با متصل کردن مستقیم مدل به سند واقعی، بهشدت کاهش میدهد.
تفاوت RAG با Fine-tuning
این دو روش، اغلب با هم اشتباه گرفته میشوند. Fine-tuning یعنی آموزش مجدد خود مدل با دادههای سازمان — روشی گران، کند، و بهمحض تغییر یک رویه اداری، نیازمند آموزش دوباره. RAG برعکس، دانش را داخل مدل «میپزد» نمیکند؛ بهجایش، هر بار در لحظه پاسخ، سند مرتبط را میخواند. یعنی وقتی یک بخشنامه عوض میشود، فقط کافی است سند بهروزرسانی شود — بدون نیاز به آموزش مجدد مدل.
RAG سازمانی در عمل چه شکلی دارد
RAG سازمانی واقعی، فراتر از یک جستوجوی ساده کلیدواژهای در چند فایل است. یک پیادهسازی جدی شامل استخراج دقیق متن از اسناد (Word، PDF، Excel)، تبدیل آنها به بخشهای قابل جستوجوی معنایی، و بازیابی هوشمند بخشهای مرتبطتر — نه صرفاً بخشهایی که کلمه دقیق سوال را دارند. دانابات این معماری را حتی در مقیاس بزرگ پیاده کرده — یکی از پروژههای واقعی آن، یکپارچهسازی RAG در یک سیستم اتوماسیون اداری با بیش از ۲۰۰۰ نمونه فعال است، بهصورت آفلاین و مبتنی بر API ساختاریافته، بدون نیاز به ارسال داده حساس سازمان به سرویسهای بیرونی.