چت بات

دانش‌کاوی دانابات: از تماس‌های ضبط‌شده سازمان، دانش و گزارش دوره‌ای استخراج کنید

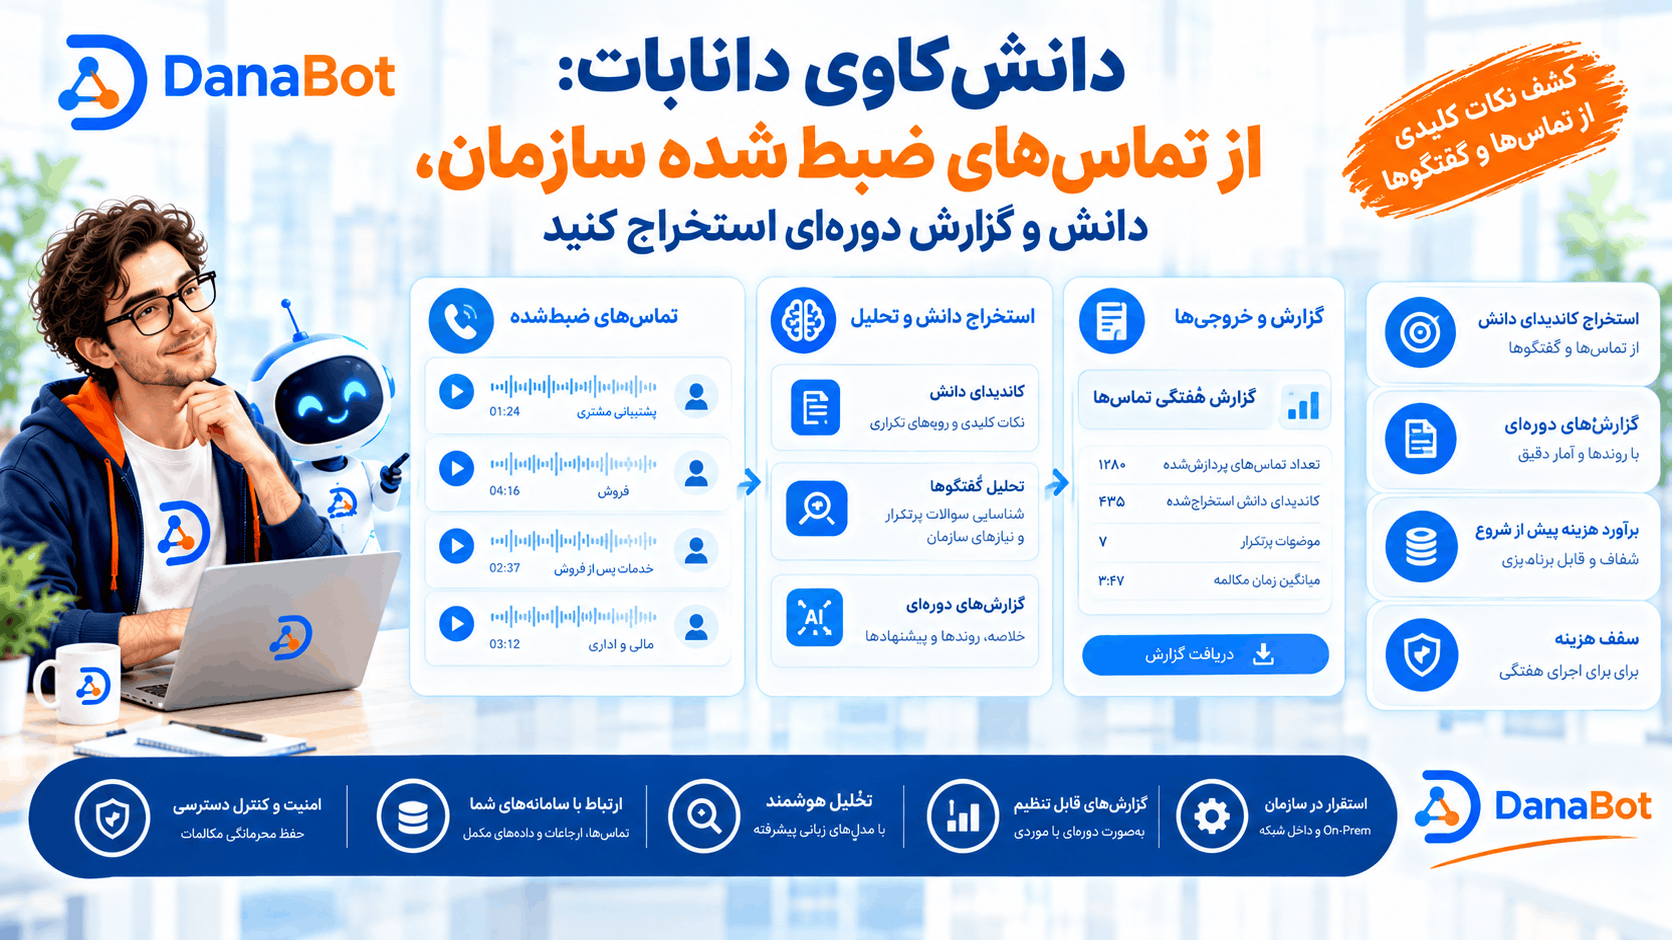
دانش‌کاوی، ماژول دانابات برای استخراج کاندیدای دانش و گزارش دوره‌ای از تماس‌های ضبط‌شده و گفتگوهای ارجاع‌شده به اپراتور است؛ با برآورد هزینه پیش از شروع و سقف هزینه برای اجرای هفتگی.

م
مرتضی علیزاده
10 دقیقه مطالعه
۵۰ بازدید
دانش‌کاوی دانابات؛ استخراج دانش و گزارش از تماس‌های ضبط‌شده
از هزاران ساعت صدا، دانش و گزارش | ArtinMag
فهرست مطالب (15 بخش)

هزاران ساعت صدا که هیچ‌کس نمی‌شنود

بسیاری از سازمان‌ها تماس‌های مشتریان و کارمندان را ضبط می‌کنند: مرکز تماس، واحد پشتیبانی، خط ارتباط با مراجعان. این فایل‌ها هر روز جمع می‌شوند و معمولاً سرنوشت یکسانی دارند: روی یک سرور می‌مانند تا فضای دیسک تمام شود یا زمان نگهداری‌شان بگذرد. فقط وقتی شکایتی پیش بیاید، کسی یک تماس مشخص را پیدا می‌کند و گوش می‌دهد.

در واقع، این فایل‌ها یکی از واقعی‌ترین منابع دانش سازمان‌اند. هر تماس نشان می‌دهد مشتری چه می‌پرسد، اپراتور چه جوابی می‌دهد، کجا گیر می‌کند و کدام سوال‌ها مدام تکرار می‌شوند. اما هیچ مدیری وقت ندارد هزاران ساعت صدا را گوش دهد.

ماژول «دانش‌کاوی» در دانابات برای همین ساخته شده است: تبدیل صدا و گفتگوی خام به دو چیز قابل‌استفاده، یعنی دانش و گزارش. پیش از ادامه، یک نکته‌ی صریح درباره‌ی وضعیت این ماژول لازم است که در بخش‌های بعد هم به آن برمی‌گردیم: دانش‌کاوی ساخته شده است، اما به صورت پیش‌فرض خاموش است و برای هر سازمان نیاز به فعال‌سازی دارد.

یک موتور، دو خروجی

دانش‌کاوی یک موتور است با دو خروجی متفاوت. خروجی اول «کاندیدای دانش» است: نکته‌ها و پاسخ‌هایی که از تماس‌ها و گفتگوها بیرون کشیده می‌شوند و منتظر تایید می‌مانند. خروجی دوم «گزارش دوره‌ای» برای مدیر است: تصویری خلاصه از آنچه در تماس‌ها گذشته است.

تفاوت این دو در سرنوشتشان است. کاندیدای دانش مستقیم وارد پاسخ‌ها نمی‌شود؛ باید از دروازه‌ی تایید عبور کند. همان منطقی که در مقاله‌ی دانش تیمی دانابات دیدیم. گزارش دوره‌ای اما برای تصمیم‌گیری مدیر است و وارد پایگاه دانش نمی‌شود.

چهار در ورود

داده‌ی خام از چهار مسیر وارد می‌شود، و این تنوع باعث می‌شود ماژول با شرایط سازمان‌های مختلف سازگار شود.

در اول، بارگذاری پوشه‌ی صوتی است. فایل‌ها به‌تدریج و یکی‌یکی ارسال می‌شوند، نه یک‌جا، که برای آرشیوهای بزرگ مهم است. در دوم، سرور ضبط تماس است. دانابات می‌تواند به سرور ضبط تماس سازمان وصل شود و مصرف منابع آن سرور را طوری محدود نگه می‌دارد که کار اصلی سرور مختل نشود. در سوم، گفتگوهایی است که به اپراتور ارجاع شده‌اند. و در چهارم، سوال‌های بی‌پاسخ است، یعنی سوال‌هایی که کاربران پرسیده‌اند و سامانه جوابشان را نداشته است.

نکته‌ی جالب در دو در آخر این است که سوال‌های بی‌پاسخ و گفتگوهای ارجاع‌شده در واقع شکاف‌های دانش سازمان‌اند. هر جا که ربات نتوانسته جواب بدهد و انسان وارد شده، احتمالاً دانشی وجود دارد که هنوز ثبت نشده است.

چرا سوال‌های بی‌پاسخ ارزشمندترین ورودی‌اند

از میان چهار در ورود، دو در آخر، یعنی گفتگوهای ارجاع‌شده و سوال‌های بی‌پاسخ، یک ویژگی مشترک دارند: آن‌ها دقیقاً نقطه‌هایی را نشان می‌دهند که دانش سازمان تمام شده است. جایی که ربات جواب نداشته و کاربر را به انسان سپرده، یا جایی که سوالی بی‌جواب مانده، یک شکاف مشخص است.

تماس‌های صوتی عمومی‌اند: بیشترشان سوال‌هایی هستند که پاسخ‌شان از قبل در سازمان وجود دارد. اما این دو در، فقط همان بخشی را به شما می‌دهند که واقعاً کم است. اگر بودجه یا زمان محدودی برای شروع دارید، منطقی است از همین دو در شروع کنید، چون هر کاندیدای دانش حاصل از آن‌ها مستقیم یک شکاف واقعی را پر می‌کند. بعد می‌توانید سراغ آرشیو صوتی بروید.

چه کسی چه گفت

دانش‌کاوی گوینده‌ها را از هم تفکیک می‌کند و هر نوبت صحبت را جداگانه رونویسی می‌کند. این قابلیت زمانی بهتر کار می‌کند که ضبط تماس‌های سازمان صدای مشتری و اپراتور را جدا ثبت کرده باشد.

چرا این مهم است؟ چون تحلیل «پاسخ اپراتور» بدون دانستن اینکه کدام جمله از اپراتور است و کدام از مشتری، بی‌معنی است. اگر همه‌چیز در یک متن واحد ریخته شود، نمی‌شود فهمید پرسش کجا بود و پاسخ کجا. تفکیک گوینده، پایه‌ی هر ارزیابی دقیقی است.

هزینه را قبل از شروع ببینید

رونویسی هزاران ساعت صدا هزینه دارد، و یکی از ایرادهای رایج پروژه‌های این‌چنینی این است که هزینه بعد از شروع معلوم می‌شود. دانش‌کاوی این مسیر را برعکس می‌کند: پیش از شروع، یک فایل نمونه رونویسی می‌شود و برآورد هزینه از روی همان نمونه محاسبه می‌شود. نرخ حدس زده نمی‌شود.

این رویکرد یک فایده‌ی جانبی هم دارد: رونویسی نمونه به شما نشان می‌دهد کیفیت متن‌پیاده‌شده‌ی صدای واقعی سازمان‌تان چقدر است. اگر صدای ضبط‌شده نویز زیاد دارد، همین نمونه آن را آشکار می‌کند، پیش از آنکه پول زیادی خرج شود.

ارزیابی هر فایل

هر تماس یا گفتگو جداگانه ارزیابی می‌شود. خروجی ارزیابی شامل چند چیز است: خلاصه‌ی تماس، امتیاز کیفیت پاسخ اپراتور، مشکلات شناسایی‌شده، احساس کلی مشتری، موضوع و برچسب. این‌ها فیلدهای ساختاریافته‌اند و بعداً می‌توان روی آن‌ها گزارش‌گیری کرد.

یک نکته‌ی احتیاطی: امتیاز کیفیت پاسخ اپراتور، یک ارزیابی ماشینی است، نه حکم منابع انسانی. اگر قرار است از آن برای تصمیم‌های مربوط به افراد استفاده شود، باید با بازبینی انسانی و نمونه‌گیری از تماس‌های واقعی همراه باشد. بهتر است از آن به‌عنوان نشانه‌ای برای اینکه کدام تماس‌ها ارزش شنیدن دارند استفاده شود، نه به‌عنوان ترازوی قطعی.

خروجی اول: کاندیدای دانش

وقتی چند ده تماس درباره‌ی یک سوال مشابه تحلیل می‌شود، الگو آشکار می‌شود: مشتریان مدام همین را می‌پرسند و اپراتورهای باتجربه یک جور جواب می‌دهند. این جواب، یک کاندیدای دانش است.

کاندیدا مستقیم وارد پاسخ‌ها نمی‌شود. از همان صف دانش تیمی عبور می‌کند و مدیر تیم آن را بررسی و تایید یا رد می‌کند. دو صف تایید وجود ندارد. این یعنی دانشی که از تماس‌ها استخراج می‌شود هم همان استاندارد کیفیتی را دارد که دانشی که کارمندی دستی ثبت کرده است.

خروجی دوم: گزارش دوره‌ای

گزارش دوره‌ای به صورت خودکار تولید می‌شود، هفتگی و بر اساس ماه شمسی. مدیر می‌تواند ببیند در این دوره چه موضوع‌هایی بیشتر مطرح شده، چه مشکلاتی تکرار شده و کیفیت پاسخ‌ها چگونه بوده است.

مهم‌ترین ویژگی این گزارش، همان قاعده‌ای است که در کل دانابات حاکم است: هر عدد drill-down دارد. اگر گزارش می‌گوید «در این هفته 30 تماس درباره‌ی فلان مشکل بود»، مدیر می‌تواند روی آن عدد کلیک کند و به تماس‌های واقعی پشت آن برسد. بدون این قابلیت، گزارش خلاصه‌ی بی‌منبعی است که نمی‌شود به آن اعتماد کرد. با آن، هر ادعا قابل‌راستی‌آزمایی است. خروجی گزارش هم به صورت Word یا Markdown گرفته می‌شود.

زمان‌بند هفتگی با سقف هزینه

برای اینکه گزارش‌ها دستی تولید نشوند، یک زمان‌بند هفتگی هست. اما بدون کنترل، یک زمان‌بند خودکار می‌تواند هزینه‌ی غیرمنتظره بسازد. به همین دلیل، زمان‌بند سقف هزینه دارد: اگر هزینه‌ی اجرا زیر سقف باشد، خودکار انجام می‌شود، و اگر بالاتر باشد، منتظر تایید می‌ماند.

این یک طراحی ساده اما حساب‌شده است: اتوماسیون کامل برای کارهای کم‌هزینه، و تصمیم انسانی برای کارهای پرهزینه.

سه سناریو از یک سازمان معمولی

این‌ها نمونه‌ی مشتریان واقعی نیستند؛ سناریوهایی‌اند که نشان می‌دهند این ماژول در عمل چه شکلی پیدا می‌کند.

مرکز پشتیبانی. مدیر پشتیبانی در گزارش هفتگی می‌بیند یک موضوع خاص، مثلاً مشکل در ورود به سامانه، در 40 تماس مطرح شده است. روی عدد کلیک می‌کند، چند تماس را گوش می‌دهد و می‌فهمد اپراتورها جواب‌های متفاوتی می‌دهند. یک پاسخ استاندارد به صورت کاندیدای دانش پیشنهاد می‌شود و پس از تایید، همه‌ی اپراتورها از همان استفاده می‌کنند.

واحد خدمات مراجعان. در یک سازمان بزرگ، مراجعان درباره‌ی یک روال اداری مدام سوال می‌پرسند. گفتگوهای ارجاع‌شده به اپراتور نشان می‌دهد ربات در یک سوال خاص جواب نداشته است. این گفتگوها وارد دانش‌کاوی می‌شوند و کاندیدای پاسخ تولید می‌شود. مدیر تایید می‌کند و سوال بعدی دیگر بی‌پاسخ نمی‌ماند.

آموزش اپراتورهای جدید. سرپرست مرکز تماس می‌خواهد بداند چه تماس‌هایی برای آموزش مناسب‌اند. با کمک امتیاز و برچسب‌هایی که برای هر تماس ثبت شده، سراغ تماس‌هایی می‌رود که اپراتور مشکل سختی را خوب حل کرده است. آن‌ها را به‌عنوان نمونه‌ی آموزشی به اپراتورهای جدید نشان می‌دهد.

فرق با نمونه‌گیری دستی

بعضی سازمان‌ها همین حالا هم تماس‌ها را بررسی می‌کنند: سرپرست هر هفته چند تماس تصادفی را گوش می‌دهد. این روش مفید است، اما دو ضعف دارد. اول، نمونه کوچک است. اگر روزانه صدها تماس داشته باشید، ده تماس تصادفی هفتگی بخش کوچکی از واقعیت را نشان می‌دهد و الگوهای نادر اما پرهزینه ممکن است هرگز در نمونه نیفتند. دوم، نتیجه روی کاغذ نمی‌ماند: برداشت سرپرست در ذهن او می‌ماند و به دانش یا گزارش قابل‌پیگیری تبدیل نمی‌شود.

دانش‌کاوی همه‌ی تماس‌ها را بررسی می‌کند و خروجی ساختاریافته می‌دهد. اما این به معنای کنار گذاشتن گوش دادن انسانی نیست. بهترین حالت ترکیب است: ماشین همه‌چیز را مرور می‌کند و الگوها را نشان می‌دهد، و انسان روی تماس‌هایی که گزارش به آن‌ها اشاره می‌کند، گوش می‌دهد. drill-down دقیقاً برای همین ساخته شده است.

محدودیت‌هایی که باید از قبل بدانید

مهم‌ترین نکته وضعیت است. دانش‌کاوی ساخته شده، اما پیش‌فرض خاموش است و برای هر سازمان باید فعال شود. پس این ماژول را نباید مثل قابلیتی دید که از روز اول در همه‌ی استقرارها روشن و در حال کار است؛ ابتدا باید برای سازمان شما فعال و پیکربندی شود.

بخش حقوقی و حریم خصوصی با خود سازمان است. تحلیل تماس‌های ضبط‌شده یعنی پردازش صدای افراد و ممکن است شامل اطلاعات شخصی باشد. اینکه چه کسانی از ضبط و تحلیل مطلع‌اند، چه رضایتی لازم است و چه مقرراتی حاکم است، یک پرسش حقوقی و سازمانی است، نه فنی. پیش از فعال‌سازی باید با مشاور حقوقی و واحد امنیت اطلاعات بررسی شود.

کیفیت رونویسی به کیفیت صدا بستگی دارد. تماس پرنویز یا با کیفیت پایین، متن ضعیف‌تری می‌دهد و همه‌ی تحلیل‌های بعدی را تحت تاثیر قرار می‌دهد.

ارزیابی ماشینی خطا دارد. امتیاز اپراتور، احساس مشتری و برچسب‌ها همه خروجی مدل‌اند و گاهی اشتباه می‌کنند. به همین دلیل drill-down و تایید انسانی کاندیداها اهمیت دارد.

و در نهایت، هزینه‌ی رونویسی واقعی است. برآورد پیش از شروع و سقف هزینه برای همین وجود دارد، اما سازمان باید از ابتدا بداند که این ماژول یک هزینه‌ی مصرفی دارد.

از کجا شروع کنیم

بزرگ شروع نکنید. یک مجموعه‌ی کوچک از تماس‌ها را انتخاب کنید، مثلاً یک هفته‌ی یک واحد. ابتدا بخش حقوقی را روشن کنید. سپس یک فایل نمونه را رونویسی کنید تا هم هزینه و هم کیفیت متن را ببینید. بعد همان مجموعه‌ی کوچک را تحلیل کنید و گزارش را با تماس‌های واقعی مقایسه کنید: آیا چیزی که گزارش می‌گوید با چیزی که واقعاً در تماس‌هاست می‌خواند؟ فقط پس از این اعتبارسنجی، زمان‌بند هفتگی را با یک سقف هزینه‌ی محتاطانه روشن کنید. برای سنجش موفقیت هم چند عدد ساده کافی است: چند کاندیدای دانش تولید شد، چند تا از آن‌ها تایید شد، و آیا موضوع‌های تکراری گزارش هفتگی بعد از تایید کاهش یافت یا نه. اگر بعد از یک ماه هیچ‌کدام از این‌ها تکان نخورد، قبل از گسترش، علتش را پیدا کنید.

اگر می‌خواهید خودتان تجربه کنید، دانابات نسخه‌ی آزمایشی 14 روزه دارد که همه‌ی ماژول‌ها در آن باز است، با محدودیت مقیاس.

برای دیدن اینکه چرا دانش نانوشته‌ی سازمان یک ریسک واقعی است، می‌توانید مقاله‌ی ممیزی دانش نانوشته در سازمان را هم ببینید.

جمع‌بندی

دانش‌کاوی صدا و گفتگوی خام را به دو چیز تبدیل می‌کند: کاندیدای دانش که از دروازه‌ی تایید عبور می‌کند، و گزارش دوره‌ای که هر عددش drill-down دارد. برآورد هزینه‌ی پیش از شروع و سقف هزینه‌ی هفتگی، آن را کنترل‌پذیر می‌کنند. مرزهایش هم روشن است: پیش‌فرض خاموش و نیازمند فعال‌سازی، وابسته به کیفیت صدا، با ارزیابی ماشینی که خطا دارد، و با ملاحظات حقوقی که بر عهده‌ی خود سازمان است.

برای دیدن این ماژول روی تماس‌های واقعی سازمان خودتان، به دانابات سر بزنید.

تحلیل آرتین

این مقاله وضعیت ماژول را صریح می‌گوید: ساخته‌شده، پیش‌فرض خاموش و نیازمند فعال‌سازی. همچنین بخش حقوقی و حریم خصوصی تحلیل تماس‌های ضبط‌شده و خطای ارزیابی ماشینی را در متن آورده است. برای ماژولی که با صدای افراد کار می‌کند، پنهان‌کردن این ملاحظات ریسک اعتباری بزرگ‌تری از ذکر آن‌هاست.

اثر بر کسب‌وکار

این مقاله دانش‌کاوی را به مسیر فروش مرکزهای تماس و پشتیبانی گره می‌زند و با ذکر برآورد هزینه‌ی پیش از شروع و سقف هزینه، مانع اصلی خرید یعنی ترس از هزینه‌ی کنترل‌نشده را هدف می‌گیرد.

در ایران

بسیاری از سازمان‌های ایرانی مرکز تماس یا پشتیبانی دارند و تماس‌ها را ضبط می‌کنند، اما تحلیل نمی‌کنند؛ این مقاله همین واقعیت رایج را هدف می‌گیرد و نیاز به بررسی حقوقی پیش از فعال‌سازی را هم یادآوری می‌کند.

سوالات متداول

دانش‌کاوی در دانابات چیست؟
ماژولی که از تماس‌های ضبط‌شده و گفتگوهای سازمان، کاندیدای دانش و گزارش دوره‌ای استخراج می‌کند.
دانش‌کاوی از چه منابعی داده می‌گیرد؟
چهار مسیر: بارگذاری پوشه‌ی صوتی، اتصال به سرور ضبط تماس سازمان، گفتگوهای ارجاع‌شده به اپراتور و سوال‌های بی‌پاسخ.
هزینه چطور پیش از شروع برآورد می‌شود؟
با رونویسی یک فایل نمونه؛ نرخ حدس زده نمی‌شود.
کاندیدای دانش چطور وارد دانش سازمان می‌شود؟
از همان صف دانش تیمی عبور می‌کند و پس از بررسی و تایید مدیر تیم ایندکس می‌شود؛ صف تایید دوم وجود ندارد.
گزارش دوره‌ای چه ویژگی‌هایی دارد؟
هفتگی و بر اساس ماه شمسی تولید می‌شود، تا تماس واقعی drill-down دارد و خروجی Word یا Markdown می‌دهد.
آیا دانش‌کاوی به صورت پیش‌فرض فعال است؟
خیر. ساخته شده اما پیش‌فرض خاموش است و برای هر سازمان نیاز به فعال‌سازی دارد.

نظرات (0)

اطلاعات شما محفوظ می‌ماند و در نظرات بعدی نیاز به وارد کردن مجدد نیست

ک
نظر شما پس از تایید نمایش داده می‌شود

هنوز نظری ثبت نشده است

اولین نفری باشید که نظر می‌دهد!