چت بات

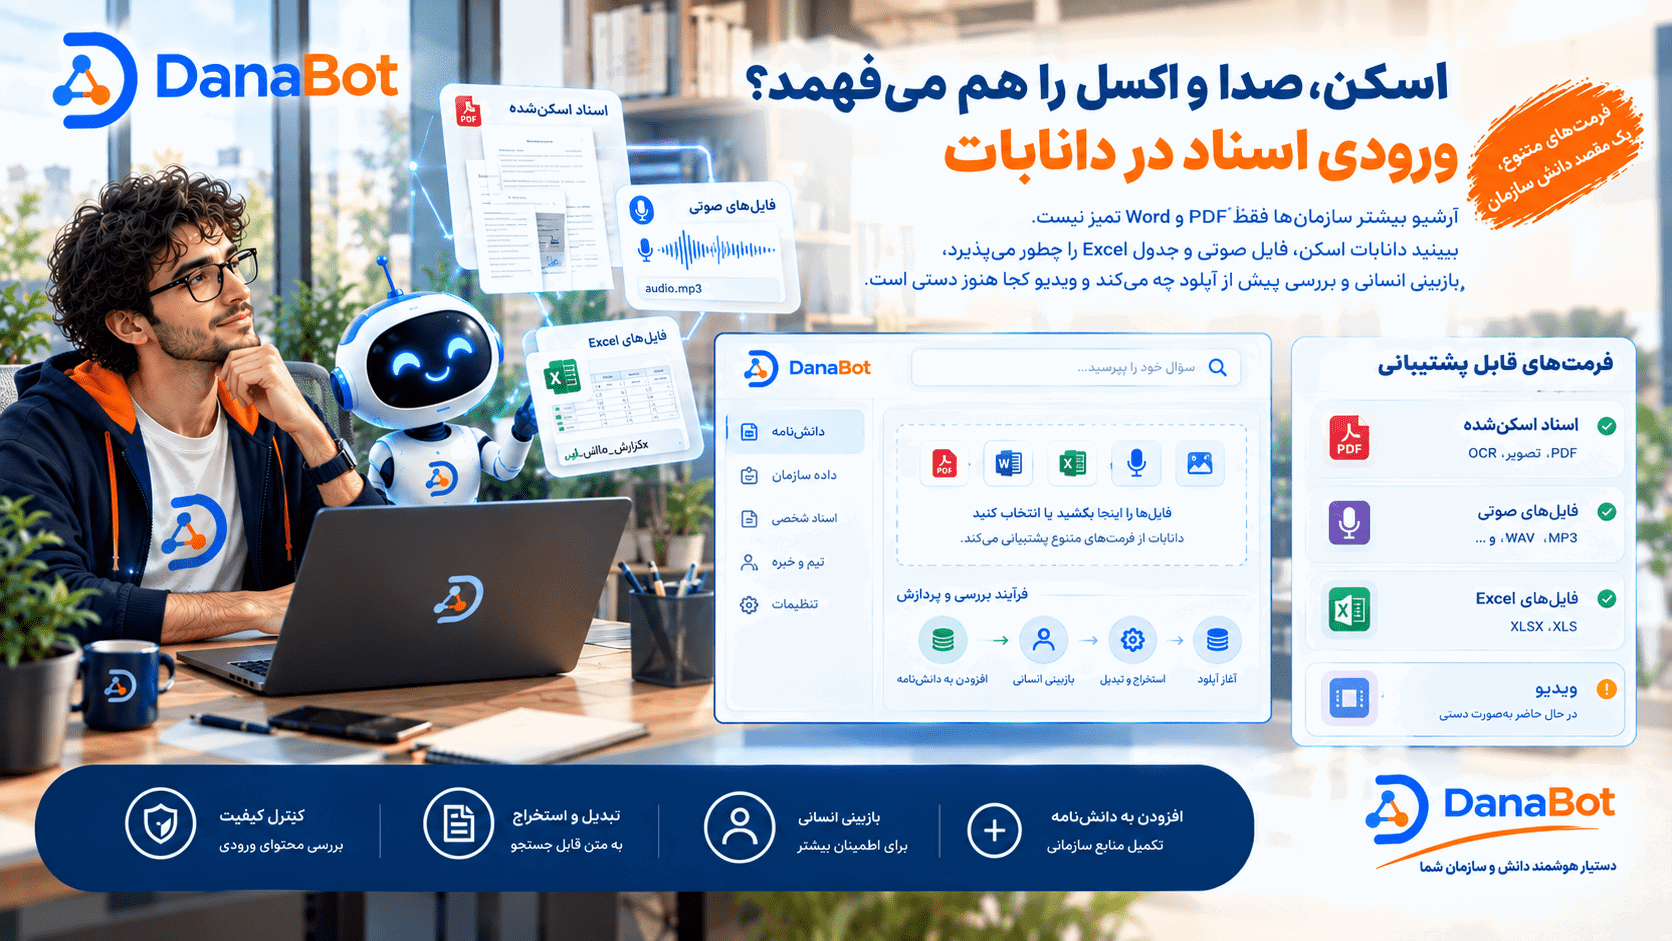
اسکن، صدا و اکسل را هم می‌فهمد؟ ورودی اسناد در دانابات

آرشیو بیشتر سازمان‌ها فقط PDF و Word تمیز نیست. ببینید دانابات اسکن، فایل صوتی و جدول Excel را چطور می‌پذیرد، بازبینی انسانی و بررسی پیش از آپلود چه می‌کند و ویدیو کجا هنوز دستی است.

م
مرتضی علیزاده
8 دقیقه مطالعه
۴۱ بازدید
ورود اسناد اسکن‌شده، فایل صوتی و Excel به دانش‌نامه‌ی دانابات
دانابات اسکن، صدا و Excel را چطور می‌پذیرد | ArtinMag

پاسخ سریع

دانابات هر فایلی را می‌پذیرد و خودش به متن استاندارد تبدیل می‌کند: سند متنی، سند اسکن‌شده، فایل صوتی، Excel و CSV و متن مستقیم. متن استخراج‌شده از اسناد اسکن‌شده می‌تواند پیش از استفاده توسط انسان بازبینی شود، صدا خودکار به متن تبدیل می‌شود و مشکلات فایل پیش از آپلود گزارش می‌شود. تبدیل خودکار ویدیو به متن هنوز ساخته نشده و رونوشت ویدیو دستی است.

فهرست مطالب (13 بخش)

«آرشیو ما فقط PDF تمیز نیست»

یکی از اعتراض‌های رایج در جلسه‌ی شناخت دانابات این است: «آرشیو ما بیشتر اسکن‌های قدیمی است، جلساتمان را ضبط می‌کنیم و قیمت‌ها در جدول‌های Excel پراکنده است. دانابات به درد این‌ها می‌خورد؟» این پرسش از جنس همان نگرانی‌هایی است که با دیدن دموی تمیز دور می‌شود، اما بعد از امضا برمی‌گردد.

این مقاله فهرست روشنی از چیزی است که دانابات می‌پذیرد، چه کاری روی آن انجام می‌دهد و چه چیزهایی هنوز دستی است یا به کیفیت فایل شما بستگی دارد. هدف این است که پیش از شروع بدانید آرشیو واقعی‌تان با چه چیزی روبه‌رو می‌شود.

اصلی که کار را ساده می‌کند: فرمت تحمیل نمی‌شود

یکی از اصول بنیادی دانابات این است که فرمت تحمیل نمی‌شود: دانابات هر فایلی را می‌پذیرد و خودش به متن استاندارد تبدیل می‌کند. الگوها فقط پیشنهادند. این اصل یک ملاحظه‌ی عملی مهم دارد: سازمان لازم نیست پیش از شروع، آرشیو خود را بازنویسی یا یکدست کند. پروژه‌ی «اول همه‌چیز را استاندارد کنیم» که سال‌ها طول می‌کشد، پیش‌شرط نیست.

انواع محتوایی که دانش‌نامه می‌پذیرد شامل سند متنی (PDF، Word و مانند آن)، سند اسکن‌شده، فایل صوتی، جدول Excel و CSV و متن مستقیم است. بقیه‌ی این مقاله به سه نوع سخت‌تر می‌پردازد: اسکن، صدا و جدول.

سند اسکن‌شده: متن استخراج می‌شود، انسان بازبینی می‌کند

اسناد اسکن‌شده در اصل تصویرند. برای اینکه بشود از آن‌ها سؤال پرسید، متن باید از تصویر استخراج شود. دانابات متن استخراج‌شده از اسناد اسکن‌شده را می‌تواند پیش از استفاده برای بازبینی به انسان بدهد.

این جمله‌ی کوتاه یک تصمیم طراحی مهم را نشان می‌دهد: استخراج خودکار متن از یک نامه‌ی اسکن‌شده‌ی قدیمی هیچ‌وقت صددرصد نیست. یک عدد اشتباه در یک بند قرارداد یا یک شماره‌ی نامه که غلط خوانده شده، می‌تواند پاسخ را گمراه کند. بازبینی انسانی قبل از ورود متن به دانش‌نامه، همان جایی است که این خطا گرفته می‌شود.

هزینه‌اش را هم باید دید: بازبینی کار و زمان می‌خواهد. اگر ده هزار نامه‌ی اسکن‌شده دارید، بازبینی همه‌ی آن‌ها منطقی نیست. معنایش این است که باید انتخاب کنید کدام اسناد ارزش بازبینی دارند.

بررسی فایل پیش از آپلود

یک ابزار کوچک اما کاربردی هم وجود دارد: دانابات مشکلات فایل را پیش از ورود به دانش‌نامه گزارش می‌دهد. نمونه‌هایی که سند محصول ذکر می‌کند، متن غیرقابل‌خواندن و جدول شکسته است.

ارزش این بررسی در این است که خطا را در مبدأ می‌گیرد، نه بعد از اینکه کاربر یک پاسخ عجیب دیده باشد. اگر یک فایل با متن ناخوانا وارد شود و کسی هم متوجه نشود، چند ماه بعد پرسشی از آن سند، پاسخی بی‌معنا می‌دهد و ریشه‌یابی سختی دارد. گزارش پیش از آپلود، این مسیر را کوتاه می‌کند.

صدا: جلسه‌ها و تماس‌ها

فایل صوتی به‌طور خودکار به متن تبدیل می‌شود. این برای سازمانی که جلسات مدیریتی یا تماس‌های پشتیبانی را ضبط می‌کند، یک منبع دانش بزرگ را باز می‌کند: تصمیم‌هایی که در جلسه گرفته شد ولی هیچ‌وقت نوشته نشد.

سه نکته را باید پیش از استفاده در نظر گرفت.

اول، کیفیت صدا روی نتیجه اثر می‌گذارد. ضبطی با نویز زیاد، چند نفر که همزمان حرف می‌زنند یا اصطلاحات تخصصی سازمان، به‌طور طبیعی متن دقیق‌تری از یک ضبط تمیز ندارد. این ملاحظه‌ای عمومی درباره‌ی تبدیل گفتار به متن است، نه جمله‌ای از سند محصول؛ با یک نمونه‌ی واقعی از ضبط‌های خودتان آن را بسنجید.

دوم، حریم خصوصی. تماس‌ها و جلسات معمولاً شامل اطلاعات شخصی و حساس‌اند. دانابات پوشش اطلاعات شخصی در پاسخ‌ها و فهرست واژه‌های حساس را دارد، اما اینکه ضبط یک تماس یا جلسه حقوقی و سازمانی مجاز است یا نه، تصمیمی است که پیش از هر چیز باید خود سازمان بگیرد. درباره‌ی این‌که چه چیزهایی نباید وارد دانش‌نامه شوند، مقاله‌ی آنچه نباید در دانش‌نامه بگذارید را ببینید.

سوم، استخراج دانش از ضبط‌ها و گزارش دوره‌ای تماس‌ها، یک قابلیت جداگانه است (دانش‌کاوی) که طبق سند، به‌طور پیش‌فرض خاموش است و باید فعال شود. تفاوتش را در مقاله‌ی دانش‌کاوی از تماس‌ها توضیح داده‌ایم. ورود فایل صوتی به دانش‌نامه، با دانش‌کاوی یکی نیست.

جدول Excel و CSV

فایل‌های Excel و CSV هم وارد دانش‌نامه می‌شوند و مثل بقیه‌ی فایل‌ها به متن استاندارد تبدیل می‌شوند. جدول‌های قیمت، فهرست‌های تأمین‌کننده و برنامه‌های زمان‌بندی، نمونه‌های معمول‌اند.

همین‌جا باید یک تمایز را روشن کرد. دانابات برای پرسش از پایگاه داده‌ی زنده ماژول جداگانه‌ای دارد (دیتابیس هوشمند) که روی SQL Server، PostgreSQL و SQLite کار می‌کند. ورود یک Excel به دانش‌نامه جایگزین آن نیست. اگر نیاز شما محاسبه و گزارش روی داده‌ی ساخت‌یافته‌ی در حال تغییر است، باید ببینید داده‌ها در یک پایگاه داده‌اند یا نه. برای جدول‌های ثابت مرجع، دانش‌نامه جواب می‌دهد.

نکته‌ی عملی: جدول‌های Excel که ساختار پیچیده یا سلول‌های درهم دارند، همان مواردی‌اند که «جدول شکسته» را می‌سازند و بررسی پیش از آپلود برای آن‌ها بیشترین ارزش را دارد.

ویدیو: آنچه هنوز دستی است

صراحتاً بگوییم: تبدیل خودکار ویدیو به متن هنوز ساخته نشده است. رونوشت ویدیو فعلاً دستی است. اگر سازمان شما آموزش‌ها یا جلسات را به‌صورت ویدیو ضبط می‌کند، باید رونوشت را خودتان تهیه کنید یا صدای ویدیو را جدا کنید و به روش صوتی بدهید.

این را اینجا می‌نویسیم چون در سند معرفی دانابات، یکی از شکل‌های منبع «زمان دقیق در ویدیو» است و ممکن است برداشت شود ویدیو خودکار پردازش می‌شود. چنین نیست؛ این یکی از قابلیت‌های در دست توسعه است و نباید در تصمیم خرید روی آن حساب کنید.

چهار سناریوی واقعی‌نما

این سناریوها فرضی‌اند و نمونه‌ی مشتری مشخصی نیستند.

سناریوی اول، دبیرخانه با آرشیو اسکن‌شده. ده سال نامه به‌صورت تصویر اسکن شده‌اند. سازمان همه را یک‌جا وارد نمی‌کند. ابتدا نامه‌های سه سال اخیر و نامه‌هایی را که بیشتر پرسیده می‌شوند انتخاب می‌کند، گزارش بررسی پیش از آپلود را می‌خواند، متن‌های استخراج‌شده‌ی مهم را بازبینی می‌کند و بقیه را به‌تدریج اضافه می‌کند.

سناریوی دوم، جلسات مدیریتی. جلسه‌ی هفتگی مدیران ضبط می‌شود و صدایش به متن تبدیل می‌شود. مدیر بعدتر می‌پرسد «در جلسه‌ی بودجه چه تصمیمی درباره‌ی پروژه‌ی انبار گرفتیم؟» و پاسخ را با منبع می‌گیرد. اما اگر ضبط پر از صحبت‌های همزمان است، سازمان باید برای جلسه‌های مهم‌تر کیفیت ضبط را بهتر کند.

سناریوی سوم، جدول قیمت تأمین‌کنندگان. چند فایل Excel با ساختار متفاوت وجود دارد. گزارش پیش از آپلود دو فایل را به‌خاطر جدول‌های شکسته علامت می‌زند. مسئول، قبل از ورود، ساختار آن‌ها را ساده می‌کند و بعد وارد می‌کند.

سناریوی چهارم، ویدیوهای آموزشی. سازمان ده ویدیوی آموزشی دارد. چون تبدیل خودکار ویدیو وجود ندارد، برای پنج ویدیوی پرکاربرد رونوشت دستی تهیه می‌کند و بقیه را به بعد می‌سپارد.

محدودیت‌هایی که باید بدانید

اول، کیفیت ورودی کیفیت خروجی را تعیین می‌کند. اسکن کم‌کیفیت، ضبط پرنویز و جدول شلوغ، هر کدام می‌توانند پاسخ را ضعیف کنند. بازبینی انسانی و بررسی پیش از آپلود این ریسک را کم می‌کنند ولی حذف نمی‌کنند.

دوم، بازبینی انسانی هزینه‌ی زمان است و برای آرشیوهای بزرگ همه‌چیز را نمی‌توان بازبینی کرد. باید اولویت‌بندی کرد.

سوم، ویدیو هنوز دستی است.

چهارم، ورود فایل به دانش‌نامه، به معنای تحلیل آن نیست. فایل صوتی یک جلسه وارد می‌شود و می‌توان از آن پرسید، اما استخراج ساخت‌یافته‌ی دانش از تماس‌ها و گزارش دوره‌ای قابلیت جداگانه‌ای است.

پنجم، دقت پاسخ‌گویی روی پرسش‌های واقعی هر سازمان اندازه‌گیری می‌شود و عدد یکسانی برای همه‌ی انواع فایل وجود ندارد. روش آن در مقاله‌ی سنجش دقت آمده است.

از کجا شروع کنیم

با یک نمونه‌ی کوچک و واقعی شروع کنید، نه با کل آرشیو. بیست تا پنجاه سند را انتخاب کنید که کاربران بیشتر از همه از آن‌ها سؤال می‌پرسند و ترکیبی از انواع باشد: چند اسکن، چند فایل صوتی و چند جدول. گزارش بررسی پیش از آپلود را ببینید، متن اسکن‌ها را بازبینی کنید و با سؤال‌های واقعی آزمون بگیرید. نتیجه نشان می‌دهد کیفیت آرشیو شما چیست و مرحله‌ی بعدی چطور باید باشد.

مسیر شروع پیشنهادی

روش پیشنهادی دانابات پنج مرحله است: جلسه‌ی شناخت، اثبات مفهوم روی بخشی از داده‌ی واقعی در یک تا دو هفته، ارزیابی با سؤال‌های واقعی در حدود یک هفته، بهره‌برداری آزمایشی در یک واحد در حدود دو هفته، و گسترش تدریجی. نمونه‌ی ترکیبی بالا دقیقاً در مرحله‌ی اثبات مفهوم جا می‌گیرد.

برای هر انتخاب، به یاد داشته باشید که اسناد قدیمی هم باید پایش شوند. نسخه‌ی اسکن‌شده‌ی یک بخشنامه‌ی منسوخ همچنان می‌تواند پاسخ بدهد؛ این را با چرخه‌ی عمر سند مدیریت کنید که در مقاله‌ی چرخه‌ی عمر سند آمده است.

اشتباهی که در این مرحله رایج است

رایج‌ترین اشتباه، بارگذاری یک‌جای کل آرشیو بدون بازبینی است. سازمان‌ها دوست دارند «همه‌چیز» را وارد کنند تا زودتر نتیجه ببینند. اما یک آرشیو بزرگ با اسکن‌های ضعیف و جدول‌های شکسته، پاسخ‌های ضعیف می‌سازد و کاربران اولین هفته‌ها را با تجربه‌ی بد شروع می‌کنند. همان‌طور که در بخش «از کجا شروع کنیم» گفتیم، کم و باکیفیت بهتر از زیاد و نامطمئن است.

اشتباه دوم، نادیده گرفتن حریم خصوصی صدا است. ضبط تماس یا جلسه بدون چارچوب روشن سازمانی، ریسک حقوقی و اعتماد دارد. پیش از ورود فایل صوتی، سیاست سازمان را درباره‌ی ضبط و نگهداری مشخص کنید.

جمع‌بندی

دانابات بدون تحمیل فرمت، سند متنی، اسکن، صدا، Excel و CSV را می‌پذیرد. متن اسکن‌شده می‌تواند پیش از استفاده توسط انسان بازبینی شود، مشکلات فایل پیش از ورود گزارش می‌شود و صدا خودکار به متن تبدیل می‌شود. محدودیت‌ها هم واقعی‌اند: کیفیت ورودی تعیین‌کننده است، بازبینی هزینه‌ی زمان دارد، ویدیو هنوز دستی است و حریم خصوصی صدا تصمیم خود سازمان است. برای دیدن اینکه آرشیو واقعی شما چطور از آب درمی‌آید، با یک نمونه‌ی کوچک و ترکیبی در دانابات شروع کنید و جلسه‌ی شناخت را درخواست کنید.

تحلیل آرتین

مقاله به‌جای وعده‌ی «هر فایلی را می‌فهمد»، مرز را روشن می‌کند: اسکن با بازبینی، صدا با تبدیل خودکار، ویدیو هنوز دستی. گفتن صریح اینکه ویدیو ساخته نشده، از برداشت اشتباهی که شاید از مثال «زمان دقیق در ویدیو» پیش بیاید جلوگیری می‌کند.

اثر بر کسب‌وکار

نگرانی از اینکه آرشیو واقعی تمیز نیست، یکی از موانع پنهان خرید است. این مقاله مسیر شروع با نمونه‌ی کوچک را نشان می‌دهد و ریسک تجربه‌ی بد در هفته‌های اول را کم می‌کند.

در ایران

آرشیو بسیاری از سازمان‌های ایرانی، به‌ویژه دولتی و دانشگاهی، شامل اسکن‌های قدیمی فارسی و فایل‌های Excel پراکنده است و کیفیت اسکن فارسی اهمیت ویژه‌ای دارد.

سوالات متداول

دانابات چه فایل‌هایی را می‌پذیرد؟
سند متنی (PDF، Word و مانند آن)، سند اسکن‌شده، فایل صوتی، جدول Excel و CSV و متن مستقیم. فرمت تحمیل نمی‌شود و دانابات خودش به متن استاندارد تبدیل می‌کند.
با اسناد اسکن‌شده چه می‌شود؟
متن استخراج‌شده می‌تواند پیش از استفاده توسط انسان بازبینی شود. استخراج خودکار از اسکن‌های ضعیف ممکن است خطا داشته باشد.
آیا ویدیو هم خودکار به متن تبدیل می‌شود؟
خیر. تبدیل خودکار ویدیو به متن هنوز ساخته نشده و رونوشت ویدیو فعلاً دستی است. صدا خودکار تبدیل می‌شود.
بررسی فایل پیش از آپلود چیست؟
مشکلات فایل مانند متن غیرقابل‌خواندن یا جدول شکسته پیش از ورود به دانش‌نامه گزارش می‌شود.
آیا ورود فایل صوتی همان دانش‌کاوی است؟
خیر. ورود فایل صوتی به دانش‌نامه جداست. دانش‌کاوی استخراج ساخت‌یافته‌ی دانش از تماس‌ها و گزارش دوره‌ای است و طبق سند به‌طور پیش‌فرض خاموش است.
از کجا شروع کنیم؟
با یک نمونه‌ی کوچک و ترکیبی (چند اسکن، چند فایل صوتی، چند جدول) از اسنادی که بیشتر پرسیده می‌شوند، نه با کل آرشیو.

نظرات (0)

اطلاعات شما محفوظ می‌ماند و در نظرات بعدی نیاز به وارد کردن مجدد نیست

ک
نظر شما پس از تایید نمایش داده می‌شود

هنوز نظری ثبت نشده است

اولین نفری باشید که نظر می‌دهد!